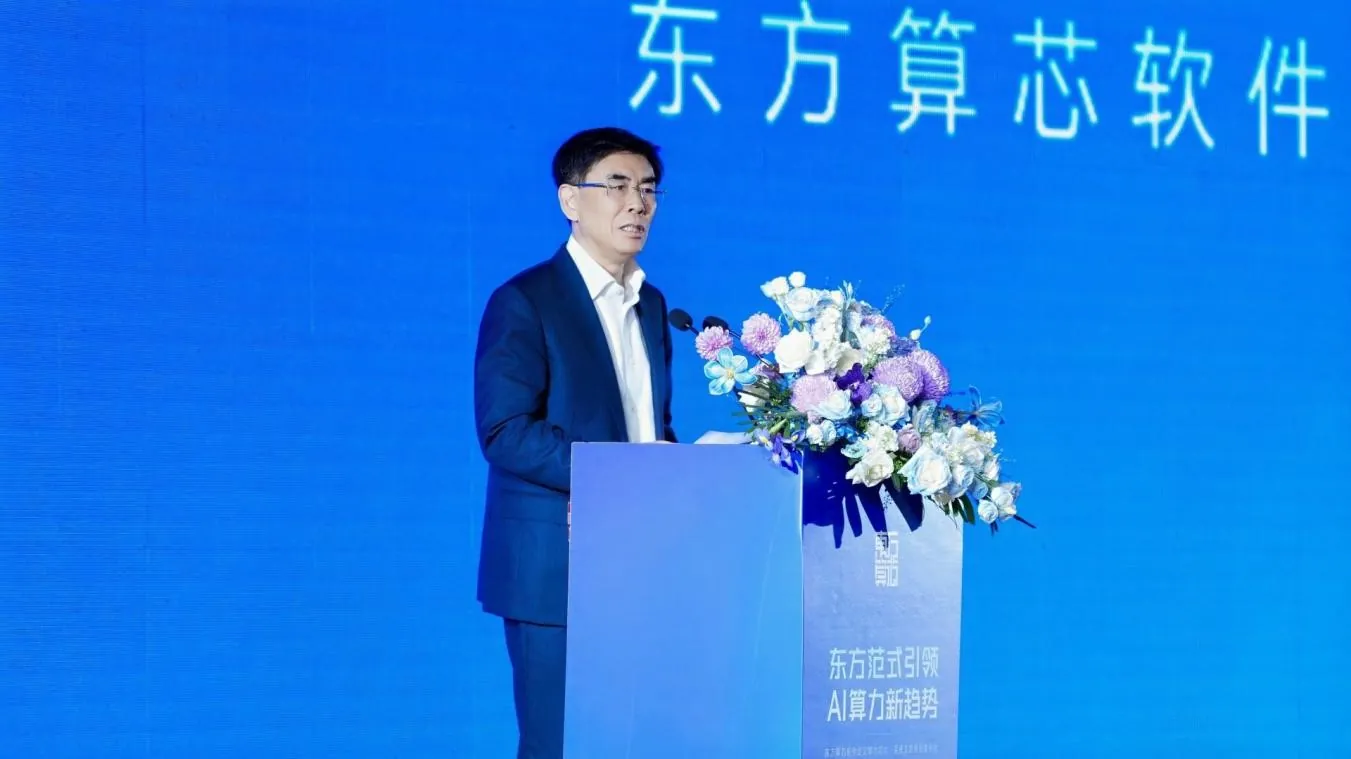
2026年7月,一颗名为DF1000的国产AI芯片引发了行业讨论。这颗由东方算芯推出的芯片,逻辑计算部分采用的是14nm工艺,但公布的BF16峰值算力达到520 TFLOPS,单芯片访存带宽6.4TB/s,卡间互联带宽900GB/s。
网上很快出现了一个说法:"14nm干翻4nm"。
这个说法吸引眼球,但容易让人错过真正值得关注的东西。
把表象问题投影到更高维的简单问题。14nm和4nm的比较也是这样——制程数字是表象,真正要回答的问题是:一颗AI芯片的整体系统效率由什么决定?
答案是三个维度:计算能力、数据搬运效率、软件生态。
DF1000选择解决的是第二个维度。当前AI芯片面临的核心瓶颈不是计算单元不够快,而是"存储墙"——GPU算力越来越强,但数据从存储搬到计算单元的速度跟不上。计算单元在等数据,这就像工厂流水线产能很大,但原材料供应卡住了。
DF1000的做法是3D近存计算:通过DRAM与Logic晶圆级混合键合,把存储和计算单元在垂直方向上"叠"在一起,缩短数据搬运距离。这比单纯缩小制程节点更直接地解决了带宽瓶颈。
所以6.4TB/s的访存带宽,比520 TFLOPS的算力数字更值得关注。
必须说清楚几件事:
第一,14nm和4nm不能通过一项算力数据直接比较谁更先进。制程决定的不只是峰值算力,还包括晶体管密度、功耗、面积、频率和制造成本。
第二,520 TFLOPS超过某款芯片的494 TFLOPS,不能证明整颗芯片的实际AI训练能力已经全面领先。不同架构、不同精度、不同测试条件下的数字,不能简单横向比较。
第三,DF1000的逻辑部分用14nm,但存储部分用的是DRAM工艺,两者是不同维度的技术。3D堆叠封装本身也是一种"先进封装"能力,不能说完全绕开了先进制造。
但DF1000的思路确实打开了一条不同的路:如果国产芯片在先进制程上短期追不上,可以通过架构创新——近存计算、3D堆叠、Chiplet——在成熟工艺上把系统效率做上去。这比硬拼制程数字更务实。
对采购AI服务器的企业来说,芯片制程是一个参考指标,但不应该是决策的唯一依据。更重要的问题是:
实际业务场景下的推理吞吐量:跑你的模型、你的数据,一张卡每秒能处理多少请求?
能效比:同样算力下,功耗是多少?电费和散热成本要算进去。
软件生态成熟度:芯片好不好用,很大程度上取决于框架适配和工具链完善程度。昇腾的CANN生态、NVIDIA的CUDA生态,各有各的成熟度。
供应链稳定性:产能是否稳定?交期多长?有没有备选方案?
商红科技在产品中心覆盖了从NVIDIA到昇腾到国产新兴芯片的完整选型矩阵。选型的核心逻辑不是追参数,而是匹配场景——不同的模型大小、并发需求、预算约束,对应不同的最优配置。
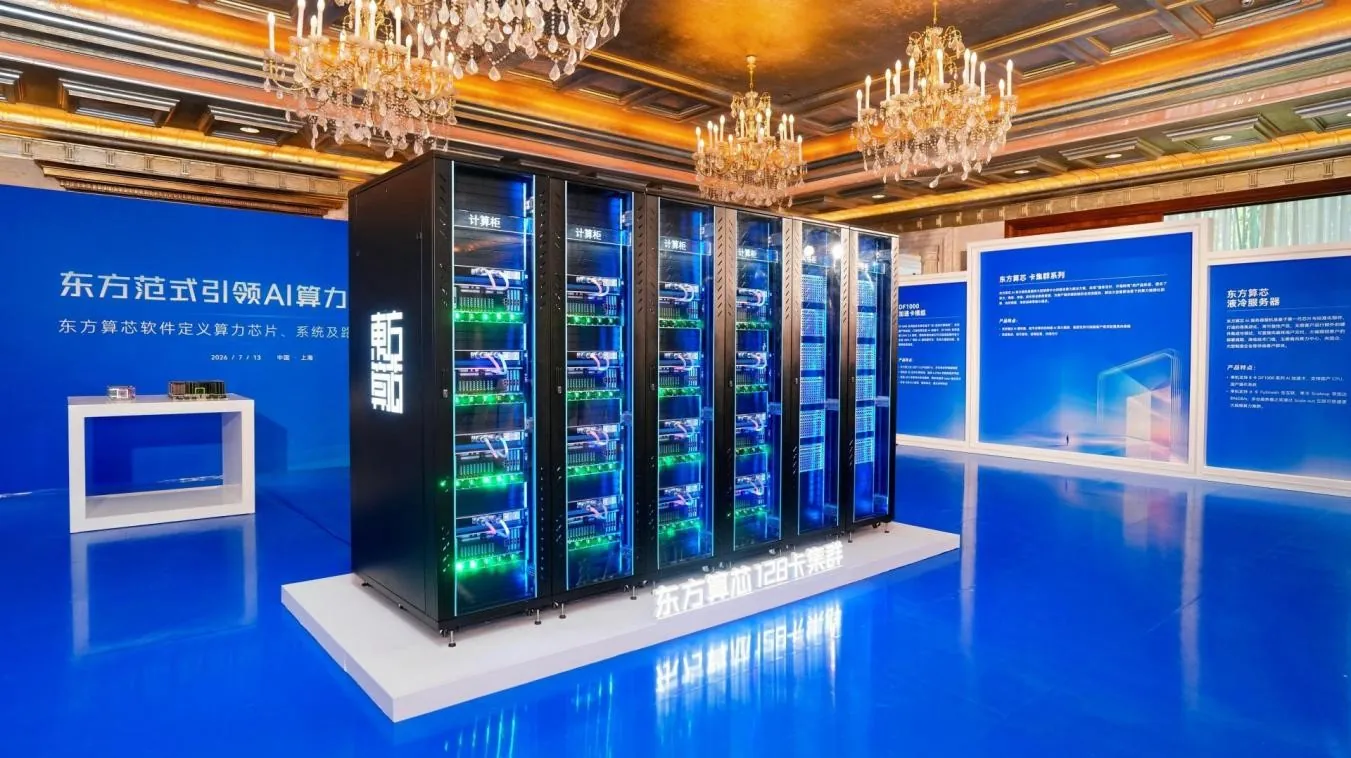
2026年国产AI芯片在国内高端市场的份额有望接近90%。这个数字背后不只有制程追赶,更有架构层面的创新。
华为昇腾910C实现量产,跑通了万亿参数大模型训练;DF1000用3D近存计算打破存储墙;超节点集群技术进入规模化商用——这些都是在不同维度上的系统性突破。
对于企业IT决策者来说,现在是一个重新评估国产AI算力的窗口期。不是每家都需要最先进的制程,但每家都需要最适合自己业务场景的系统效率。
商红科技作为IT基础架构解决方案提供商,可以帮你做一次全面的算力需求评估。从高校AI训练到政企私有化部署,从智能制造到金融量化,不同场景的选型逻辑差异很大。先搞清楚你的场景,再选芯片——这才是正确的顺序。
联系我们做一次需求沟通,不收费,但可能帮你省下不少冤枉钱。
电话:
座机:400-0755-816
手机:13316351745
把制程数字放到一边,这四项更决定你买到手之后的实际体验。
| 核对项 | 为什么重要 | 怎么向供应商核 |
|---|---|---|
| 架构与近存设计 | 决定数据要在计算单元和存储之间搬多少次,直接影响算力和功耗 | 要一份架构说明,写清近存单元与主存之间的带宽关系 |
| 显存容量与带宽 | 决定能放下多大的模型、并发能开到多少 | 要单卡容量与实际可达带宽,不只看理论峰值 |
| 软件生态与算子支持 | 决定模型能不能直接跑,也决定迁移要花多少人力 | 要一份已验证的框架与模型清单,而不是"兼容主流框架"这种说法 |
| 整机供电与散热 | 高功耗卡对机柜是硬约束,装不下就是装不下 | 要单机功耗、风冷或液冷方案,以及机柜的配电与散热要求 |
DF1000 用 14nm 真的能超过 4nm 吗?
这个说法要有限定条件。制程数字是表象,真正决定表现的是整颗芯片的系统效率——架构、近存设计、带宽利用方式共同起作用。
520T 算力和 6.4TB/s 带宽意味着什么?
这是厂方公布的口径。对采购来说更该关心的是:这套带宽在你的模型和并发下能不能真正用起来,而不是账面数字多大。
买 AI 服务器该看制程还是别的?
制程是参考指标,不该是唯一依据。先看你的模型、并发、软件生态和机柜条件,再回头判断这颗芯片合不合适。
国产 AI 芯片的竞争在换什么赛道?
从单纯追制程,转向架构层面的创新,比如近存计算和超节点这类系统级方案。
需要把这颗芯片放进你的实际负载里核一遍,可以联系我们(400-0755-816),把模型和并发说清楚,我们回一版判断。
结合 13 年 IT 基础架构交付经验与原厂授权资源,按场景评估配置、交期与预算 —— 1 个工作日内给出可行性结论,先沟通需求,再定方案
扫码关注