算力缺口越来越大
科研算力需求指数级增长,高性能计算环境搭建难、维护贵,难以支撑大规模并行计算与 AI 训练。课题组排队等机器,模型训练与仿真任务一拖再拖。
科研算力需求指数级增长,高性能计算环境搭建难、维护贵,难以支撑大规模并行计算与 AI 训练。课题组排队等机器,模型训练与仿真任务一拖再拖。
实验数据分散在师生终端与各自业务系统,缺乏统一汇聚治理,跨院系 / 院校协同效率低,成果难以复用。设备与仪器数据同样缺少统一入口。
科研项目全流程管理不规范,数据隐私、知识产权安全与等保定级要求严苛,审计追溯难度大。安全建设常与业务上线脱节,测评时才发现缺口。
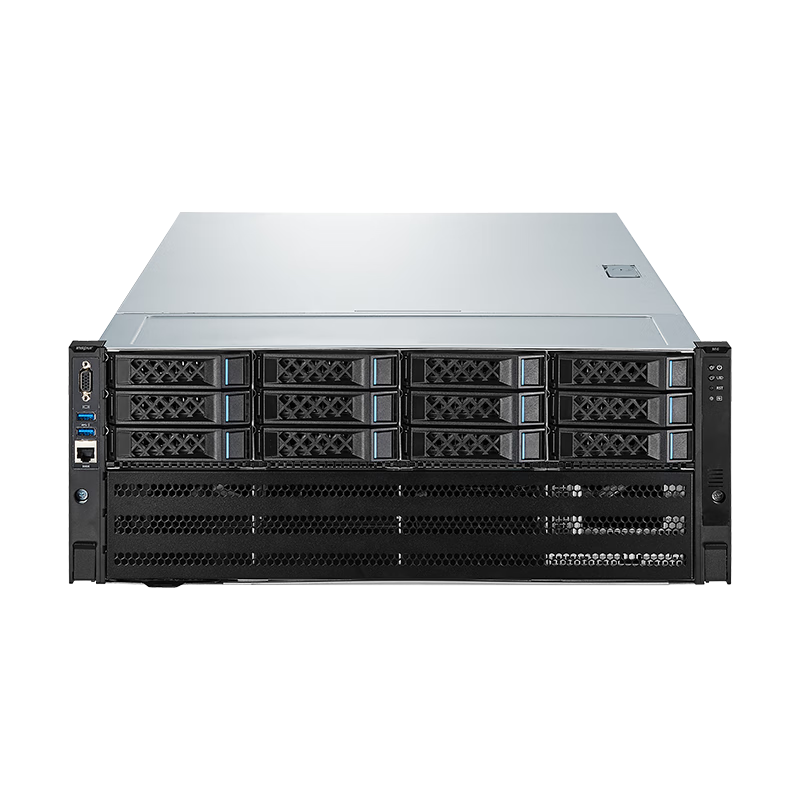
把 HPC 计算集群、GPU 训练集群与图形工作站池化成一个公共资源池:统一调度、按需申请、配额与计费计量,InfiniBand / RoCE 组网降低多节点并行开销。原先各课题组分散采购、各自闲置的算力,在这里变成可复用的资源;已落地高校项目模型训练效率提升 4 倍、算力利用率达 70% 以上。
计算、存储、网络一体化,节点级加入即并入资源池,随学科增长线性扩展,不必一次投入到位;NVMe 全闪 + HDD 容量层冷热自动分层,多副本与快照支持任意时间点恢复,原有存储还能作为二级或归档层继续用。
实验数据、仪器数据与成果资料统一入湖,跨院系 / 跨校区按权限互通,一处存放、多点访问;联合课题不再靠拷贝硬盘推进,历史实验记录随时可查、可复算。
等保 2.0 定级备案所需的边界防护、主机安全与微隔离、数据加密与防泄密、漏洞扫描修复、全链路日志审计一次建齐,配套异地容灾与快照恢复;安全策略与业务同步交付,测评不再临时补建。
2600+ 服务站点、1000+ 认证技术工程师,响应时效小于 30 分钟;准备 → 上门 → 实施 → 验收四步标准化流程,设备出厂预装联调、现场实施通常 4 至 6 周,核心业务切换可安排在寒暑假窗口。
特殊软件、跨学科场景或设备兼容需求,都可以直接告诉我们。
深耕 IT 领域,兼具浪潮 / 联想原厂品质,更享灵活深度定制与极速供货;提供从 HPC 集群搭建、存储网络部署到算力调优的一体化服务。
左右滑动浏览全部资质,点击证书查看大图。
按建设层级分三档:课题组 / 实验室级通常几十万起;学院级共享平台百万级起;校级平台或科研院所按节点规模与 GPU 卡数上百万至千万级。已落地的高校项目均为百万级,并支持按年度分批扩容,不必一次投入到位。
按主要负载划分:大规模并行仿真、CFD、气象与结构计算以 CPU 为主,适合 HPC 集群;AI 训练、大模型推理与图像处理需要 GPU 集群。多数高校的实际形态是两者混搭,由统一算力调度平台按课题组分配。
可以。采用超融合架构时计算、存储、网络一体化,支持节点级线性扩容,新节点加入即并入资源池,扩容周期可缩短至小时级;原有存储设备可作为二级或归档层继续使用,避免一次性替换造成浪费。
覆盖等保 2.0 定级备案所需的边界防护、主机安全与微隔离、数据加密与防泄密、漏洞扫描与修复、全链路日志审计留存,以及异地容灾与快照恢复。安全策略随业务上线同步交付,便于测评取证。
设备出厂预装并完成联调,现场实施通常 4 至 6 周,走标准化的准备、上门、实施、验收四步流程。涉及核心业务切换可安排在寒暑假窗口,并按业务分批割接,避免影响教学科研。
提供 7×24 远程值守与统一监控告警平台,响应时效小于 30 分钟,2600+ 服务站点覆盖全国可提供上门支持,并包含巡检、维保与故障应急处理。同时支持管理员培训,帮助校内团队逐步接手。
扫码关注