先给最容易踩的那个坑:AI训练GPU工作站的「能推理」和「能训练」是两笔账,显存差 8 倍左右。 全参微调的显存系数约 16 字节/参数,FP16 推理约 2 字节/参数。所以你在别处看到的"24G 显存能跑 32B 模型",说的是推理;同一个模型拿去训练,要按 8 倍去算。这篇按采购决策的顺序走:先算账,再分档,再定工作站与服务器的边界,最后给你六个可以直接写进采购文件的参数。
训练要占显存的不是一样东西,是四样。
| 占用项 | 推理时 | 训练(全参微调)时 | 说明 |
|---|---|---|---|
| 模型权重 | 有 | 有 | 推理只需一份;训练通常还要一份高精度副本用于更新 |
| 梯度 | 无 | 有 | 只有反向传播才产生 |
| 优化器状态 | 无 | 有 | Adam 类优化器要为每个参数保存一阶、二阶动量,这是最大的一块 |
| 激活值 | 少量 | 大量 | 训练要保存中间激活用于反向传播,随批量与序列长度增长 |
三档经验系数(不含激活值、KV Cache、通信缓冲与显存碎片):
| 用途 | 经验系数 | 主要构成 |
|---|---|---|
| FP16/BF16 推理 | 约 2 字节/参数 | 权重 |
| INT4 量化推理 | 约 0.5–0.6 字节/参数 | 量化权重 + 少量反量化开销 |
| LoRA 等参数高效微调 | 约 4 字节/参数起 | 冻结的基座权重 + 小规模可训练参数及其优化器状态 |
| 全参微调(混合精度 + Adam) | 约 16 字节/参数 | FP16 权重 2 + FP16 梯度 2 + FP32 主权重 4 + Adam 一阶 4 + Adam 二阶 4 |
划重点:16 ÷ 2 = 8 倍。 这就是为什么同一个模型"能推理"却"训不动"。把这个倍数告诉你的采购负责人,比告诉他"显存要大一点"有效得多——它直接决定预算档位。
这个误判在采购里的具体代价:按别处的推理显存表配了一台 24G 卡的工作站,准备做 7B 全参微调。按 16 字节/参数算,7B 需要约 112GB 显存——一台单卡 24G 的机器差得不是一点。结果是要么加卡、要么改方案,中间的时间成本比硬件差价高。
顺带说清一件事:统一内存 ≠ 显存。 近两年出现的统一内存架构设备(如 GB10 平台的桌面 AI 工作站)把内存与显存合到一个池子里,容量数字很好看,但带宽特性与专用显存不同,训练时的实际吞吐要按真实测试判断,不能拿容量数字直接套显存口径。第五节会讲到为什么这一点在今年尤其重要。
这对你的配置单意味着什么:拿到任何一张"显存对照表",先问它是推理表还是训练表;不标的,按推理表处理。
算式只有一行:
所需显存 ≈ 参数量 × 系数 × (1 + 余量)复制
系数取第一节那三档;余量是下面这四项,必须留:
| 余量项 | 什么时候显著变大 | 实务口径 |
|---|---|---|
| 激活值 | 批量越大、序列越长、模型越深,涨得越快 | 长序列任务要单独放大 |
| KV Cache | 只在推理与生成式训练中出现;序列长、并发高时占比大 | 按上下文长度 × 层数 × 并发估 |
| 通信缓冲 | 多卡并行(数据并行/张量并行)时出现 | 多卡必须单独留 |
| 显存碎片 | 长时间训练、频繁分配释放 | 通常预留一定比例 |
一个假设推演算例(以下为便于说明的假设值,非实测):
假设你要对一个 7B 参数的模型做全参微调,序列长度中等、单卡:
权重与优化器状态:7B × 16 字节 ≈ 112 GB
激活值 + 碎片 + 通信缓冲:按 20%–40% 估 → 再加 22–45 GB
合计约 134–157 GB
这个量级已经超出一台塔式工作站的单机舒适区,需要多卡分摊或改参数高效微调。而如果只做推理,同一个模型按 2 字节/参数只要约 14GB,一张 16G 卡就够。 两者相差近 10 倍——这就是第一节那个倍数在真实预算上的样子。
再看同一模型的 LoRA 路径(假设推演):基座按 2 字节/参数 ≈ 14 GB,加上少量可训练参数与其优化器状态、激活值,经验上按 4 字节/参数起算约 28 GB,再留余量后落在 35–45 GB 区间——一张 48G 卡或两张 24G 卡可以承载。
划重点:训练方式的选择,比显卡档位的选择更省钱。 从全参微调换成 LoRA,显存需求可能降到 1/4,而多数业务场景的效果差距并没有那么大。先定训练方式,再定显存档位,最后才定机型——顺序反了就是白花钱。
这对你的配置单意味着什么:在需求说明里写清三件事——模型参数量、训练方式(全参/LoRA/仅推理)、最大序列长度。这三项不写,供应商只能按最坏情况报配置。
下面这张表是本文的核心交付物之一。显存档位按第一节系数推导,机型方向取自渠道在售的真实配置,只作档位参照。
| 档 | 模型规模与方式 | 显存需求(含余量,经验推算) | 形态 | 机型方向 |
|---|---|---|---|---|
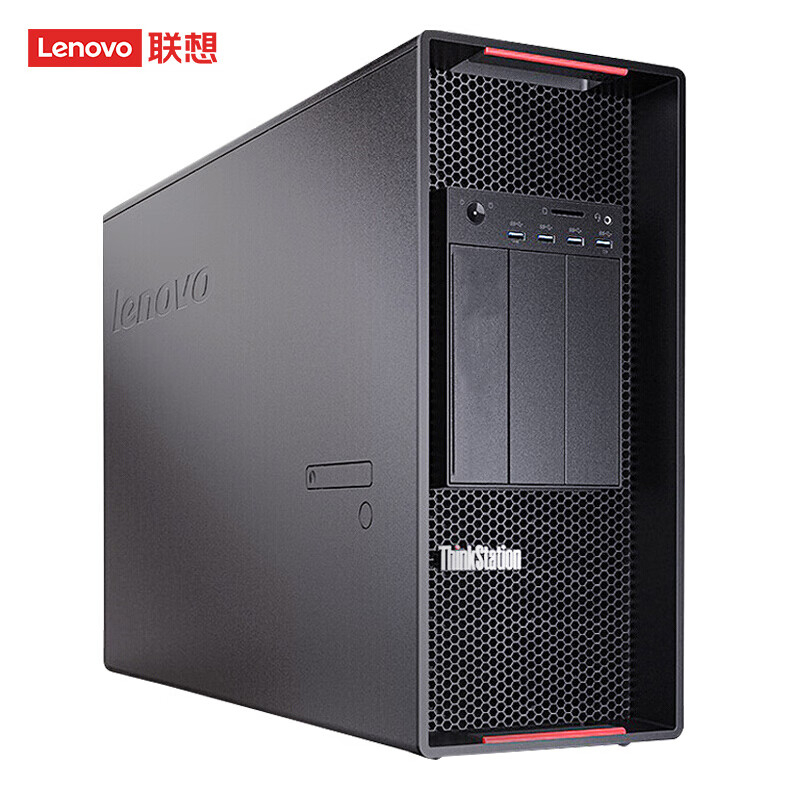
| 第一档 实验 / 入门 | 7B 以下 LoRA 微调;任意规模仅推理 | 16–48 GB | 单卡塔式 | 联想 ThinkStation P3 Gen2(Ultra 7 265 / 64G / RTX 5070Ti 或 5080 16G) |
| 第二档 单卡主力 | 7B–14B LoRA;小模型全参 | 48–96 GB | 单卡塔式(大显存) | 联想 ThinkStation P3 Gen2(Ultra 9 285K / 128G / RTX 5090D V2 24G)或 RTX 5 系 32G 显存档 |
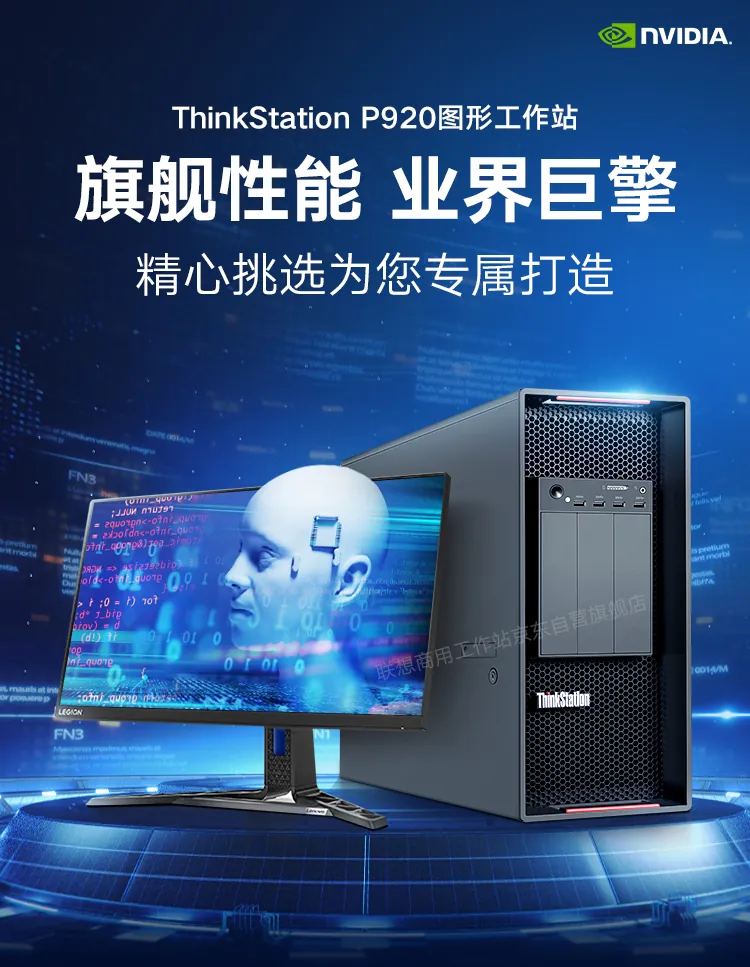
| 第三档 双卡 / 课题主力 | 14B–32B LoRA;7B–14B 全参 | 96–200 GB | 双卡塔式 | 联想 P8 图形工作站、联想 P7 图形工作站、联想 P920 |
| 第四档 多卡 / 多人共用 | 32B–70B 级训练;多任务并行 | 200 GB 以上 | 塔式旗舰或机架式 | 联想 PX 工作站、元脑浪潮 NF5468M7、数聚红芯 HG9680 |
| 信创专项 | 合规要求优先于性能 | 按模型定 | 塔式 / 机架 | 数聚红芯 HI5228 AI 一体机(鲲鹏 920S / 128G / Atlas 300I A2) |
怎么用这张表:先按第二节的三件事(参数量 / 训练方式 / 序列长度)算出显存需求,再落到某一档,然后才看那个档位里的具体机型。不要从机型看起——从机型看起,你买到的一定是那台机器,而不是你需要的显存。
显存档位怎么换算成"能跑多大模型"的口径,站内《96G 显存能跑多大模型?先分清是哪一种 96GB》拆得更细。
这是被问得最多、也最容易买错的一个边界。它不是"哪个好",是"在哪一步必须换"。
| 卡数 | 形态 | 物理约束 | 部署位置 |
|---|---|---|---|
| 1 卡 | 塔式工作站 | 常规市电即可,噪音可控 | 工位旁、实验室桌面 |
| 2 卡 | 塔式工作站 | 需确认电源功率档位与机箱散热余量;要核对显卡间距与气流 | 工位旁、实验桌下 |
| 3–4 卡 | 塔式(旗舰)或机架 | 进入分界线:整机功耗显著抬升,需核对配电回路、UPS、空调与承重;多卡还要看卡间互联拓扑是否支持你需要的并行方式 | 通常建议进机房或专用机柜 |
| 8 卡 | 机架式 | 整机电源可达 3000W ×4 量级;机房配电、UPS、制冷、承重通常要改造 | 机房 |
划重点:塔式工作站的天花板不在显卡,在电和热。 一台塔式机放进办公室,2 卡通常还稳;到 3–4 卡,你要先问的是"这间屋子的这条回路还能挂什么、空调压不压得住、以后谁会抱怨噪音",而不是"这张卡跑分多少"。这几件事在立项阶段就要和设备科、后勤一起过,等到货再谈就晚了。
站内《大模型本地部署选型:联想工作站还是浪潮服务器?双品牌AI算力方案》讲的是负载怎么分,本篇只讲"几张卡换形态"这条线,两篇不重复。
这两个变量不是背景,是会直接改变你那张配置单和预算表的东西。
据上海有色网(SMM)2026-10-10 市场跟踪(原文):
装备 GB10 芯片、128GB 统一内存的 NVIDIA DGX Spark,国内渠道报价从 9 月 20 日的 37,500 元/台涨至 10 月 10 日的 42,500 元/台,三周涨 5,000 元(13%);
英伟达官方定价年内两档上调:128GB 版本从 2025-10-15 发布时的 3,999 美元 → 2026 年 2 月调至 4,699 美元 → 10 月 2 日再调至 6,000–6,500 美元;
10 月 5 日发布的 64GB 新版本起售价 4,999 美元——内存减半,价格反高于一年前的 128GB 版本;
10 月 7 日微软发布 Surface RTX Spark 开发主机;加上宏碁、华硕、戴尔、新华三、联想等九家厂商的 GB10 架构产品,桌面级 AI 设备已从单品成为品类。
对你的配置单意味着什么:①"在桌面本地跑模型"这个需求已经成立到能撑起一个硬件品类,不再是实验性质;②内存容量正在变成定价的主导变量——内存减半而价格更高的定价结构,说明厂商在为内存付的钱比你在配置单上看到的更多;③统一内存架构的产品要按实测吞吐评估,不能按容量数字套显存口径(回到第一节那条提醒)。
NVIDIA 官方对这类产品的定位与支持模型范围,可看其产品页与官方博客。
同一份 SMM 跟踪:
华东地区 5090 八卡服务器月租:9 月初 1.35 万元/台/月 → 10 月 10 日 1.6 万元/台/月,涨 18.5%;
5090 单卡华南报价:9 月 17 日 46,800 元/张 → 10 月 10 日风扇卡 50,500–51,000 元、涡轮卡 53,000–54,000 元(含税),三周涨 8%–9%;
SMM 算力租赁价格综合指数 8 月以来总涨幅约 26%。
另有报道提到,2026 年 3 月华硕联席 CEO 许先越在财报会议表示,受 AI 需求驱动内存采购成本环比涨幅已超过一倍(SMM 报道转述)。
对你的配置单意味着什么:训练工作站的价格不再是"硬件成本",而是"当期行情"。 所以采购文件里必须补两项——
| 要补的项 | 为什么 | 怎么写 |
|---|---|---|
| 报价有效期 | 三周内单卡价格可动 8%–9%(SMM 口径) | 写明"报价有效期至 X 月 X 日" |
| 价格口径 | "内存涨了 X%"有合约价与现货价两种说法,不能混用 | 要求注明内存/显卡按哪个口径报 |
站内《AI工作站价格差异大原因》把报价分层拆过(显卡档位、平台、整机形态、渠道层级、交付服务、采购时点),本篇这一节只补"当期行情"这一层,方法不重复。
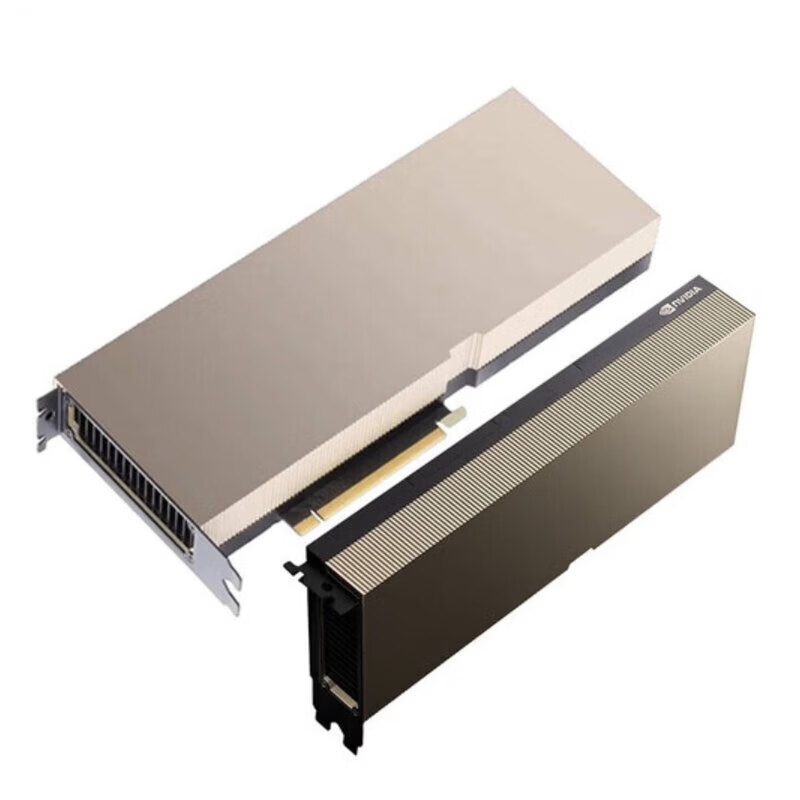
下表机型与参数取自渠道在售的代表配置,只作档位参照;写进合同附件前请让供应商附上原厂规格书,以原厂口径为准。
| 档 | 机型方向 | 关键参数 | 适合谁 | 别这么选 |
|---|---|---|---|---|
| 第一档 | 联想 ThinkStation P3 Gen2 | Ultra 7 265 / 64G 内存 / 1T 固态 + 4T 机械 / RTX 5070Ti 或 5080 16G | 单人实验、推理为主、7B 以下 LoRA | 别拿它做 7B 以上全参微调 |
| 第二档 | 联想 ThinkStation P3 Gen2 | Ultra 9 285K / 128G 内存 / 1T 固态 + 8T 机械 / RTX 5090D V2 24G;或 RTX 5 系 32G 显存档 | 单卡主力,7B–14B LoRA、小模型全参 | 别只加显存不加内存——数据加载会先卡 |
| 第三档 | 联想 P8 / P7 / P920 | 高主频多核 + 双卡位;下单前必须核电源功率档位与卡间距 | 课题组主力机、双卡并行 | 别忽略配电回路余量 |
| 第四档 | 联想 PX / 元脑浪潮 NF5468M7(6530×2 / 64G×4 / 1.92T×2+8T×2 / 80G 显卡 / 3000W×4)/ 数聚红芯 HG9680 | 多卡 + 高压配电;机架形态要算机房改造 | 多人共用、32B–70B 级 | 别把机架式塞进普通办公室 |
| 信创专项 | 数聚红芯 HI5228 AI 一体机 | 鲲鹏 920S / 128G / 4T / Atlas 300I A2;国产平台整机 | 项目带信创考核、数据不出内网 | 别按 X86 的配置单照抄 |
表里的机型取自商红科技在售渠道的代表配置,只作档位参照——写进合同附件前,请让供应商附上原厂规格书,以原厂口径为准。
双卡怎么配,站内《联想 ThinkStation P5 Gen 2 双卡配置指南:8档专业显卡怎么选、功耗怎么算》有逐档拆解;离线跑大模型的问题,《联想 ThinkStation PGX 能不能离线跑大模型?》把六个选型问题逐条答过,正好对应第五节的统一内存话题。
下面六项建议直接写进需求文件的技术参数栏。只写"显卡型号"是不够的——那是供应商最容易含糊过去的地方。
| # | 参数 | 为什么必须写 | 去哪核 |
|---|---|---|---|
| 1 | 显存档位与单卡容量 | 决定能训练还是只能推理;"合计 96G"可能是 2×48G,也可能是 1×96G,训练路径完全不同 | 原厂规格书 |
| 2 | 内存容量与运行速率 | 数据加载瓶颈在这里;且同一句"128G DDR5"可能因 CPU 档位被限制速率 | 原厂规格书(带料号) |
| 3 | 电源功率档位与冗余 | 多卡训练的硬顶;也是机房配电改造的输入条件 | 原厂规格书 |
| 4 | 卡间互联与 PCIe 拓扑 | 决定多卡并行效率,是"账面卡数"之外的第二个变量 | 原厂规格书 |
| 5 | 整机料号 | 区分品牌整机与准系统拼装;关系到原厂整机保修与单一责任方 | 原厂机型库 |
| 6 | 报价有效期与价格口径 | 当期行情波动大(第五节),不写清楚验收时会对不上账 | 合同条款 |
规格书怎么查:联想侧有公开的 PSREF 规格书入口(psref.lenovo.com),可以按具体机型料号查到内存槽位、速率、电源档位、显卡上限。ISV 认证与授权链的核验方法,站内两篇写得更细:《买工作站前必看:ISV认证清单怎么查?》和《政府采购联想工作站授权链怎么验证?》。
这类采购的返工原因高度集中在四处。写出来是模式,不是某一家的具体项目。
错配一:拿推理显存表配训练机。 第一节那 8 倍差异,几乎全部来自这一条。看到"某卡能跑 32B"就下单做微调,到货才发现差一个数量级。
错配二:先定机型,再倒推需求。 正确的顺序是参数量 → 训练方式 → 序列长度 → 显存需求 → 机型和卡数。反过来做,你买到的是那台机器,不是你的需求。
错配三:只算显存,不算内存与存储。 显卡到位、数据加载卡住,是这类工作站的经典症状。训练要持续读数据集、写 checkpoint,内存容量与存储 IOPS 是两个独立瓶颈。
错配四:忽略配电与散热,把机房问题留到到货那天。 3 卡以上就要过电力与空调这关。立项预算里只写了服务器、没写机房改造,项目大概率会在到货那天停下来。
顺序是:定训练方式 → 算显存需求 → 定卡数和形态 → 再选机型。 三步走完,配置单基本就收敛了。
定训练方式:全参还是 LoRA,这一项对显存的影响比显卡档位更大。
算显存需求:参数量 × 系数 × (1 + 余量)。系数取 2(推理)/ 约 4(LoRA)/ 约 16(全参)字节每参数。
定卡数和形态:1–2 卡塔式、3 卡以上考虑机房,这条线由电与热决定,不由显卡决定。
这三个数(模型参数量、训练方式、最大序列长度)定下来,你的需求文件就写得出、供应商的报价就可比了。
按商红官网「关于商红科技」页的公开表述,商红科技是联想-政企增值代理商(钻石)、浪潮金牌增值合作伙伴、戴尔钛金级合作伙伴,做多品牌工作站与服务器的选型、交付与售后。多品牌位置对采购方有用的地方在于:同一次询价里,工作站与机架式两个方向、Intel 与国产两个平台可以一起比,而不是只拿到供应商自己拿货的那一个方向。 这组合作层级只说明报价背后有一条可核对的授权与售后链路,不代表任何一台机器在你这类负载上就够用——那要按上面的显存账自己算。
如果你手上已经有一份配置单或报价,可以把模型参数量、训练方式(全参/LoRA/仅推理)、最大序列长度这三项发过来,商红科技的选型工程师先帮你把显存需求和卡数过一遍,并指出哪些栏目其实不需要加钱。这一步不收费。
全国统一服务热线:400-0755-816 | 邮箱:IT@bencom.cn | 联系我们,提交项目需求
延伸阅读
2026-08-21
2026-08-24
2026-08-24
2026-08-25

2026-08-26
2026-08-26
2026-08-27
2026-09-02
2026-09-02
扫码关注