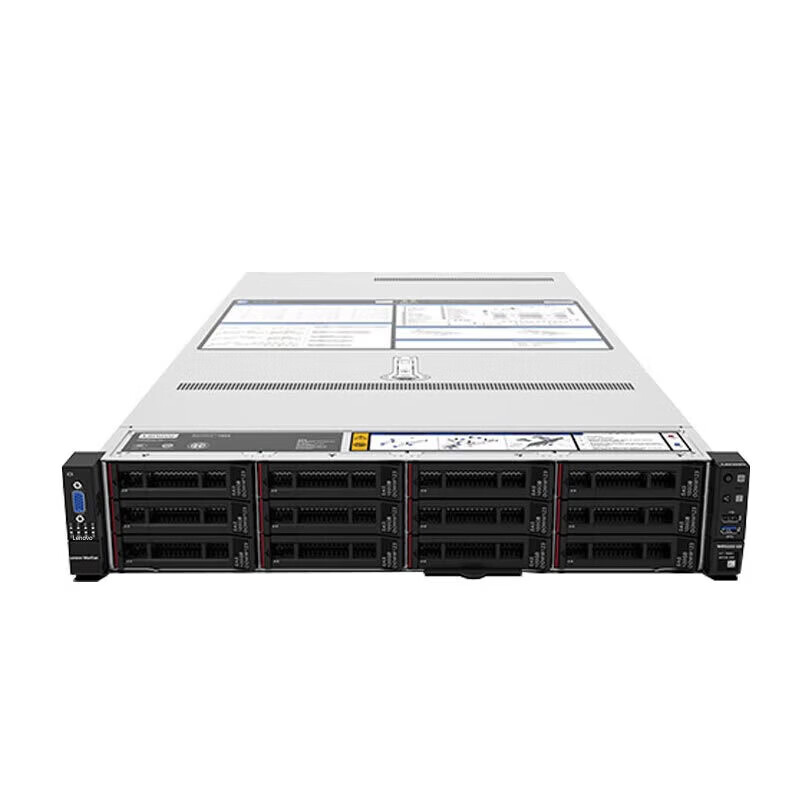
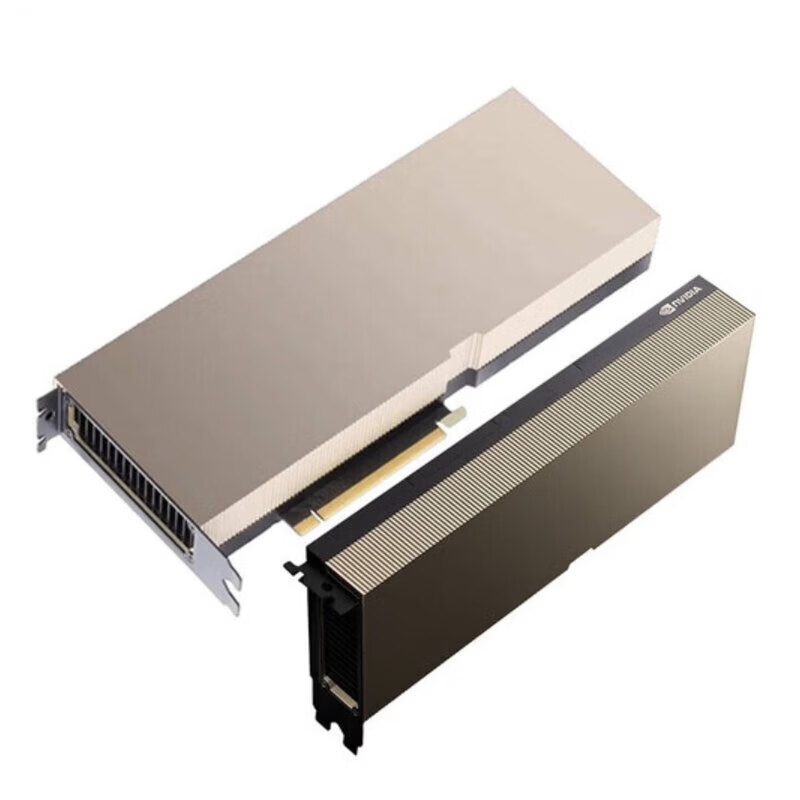
70B 模型做 FP16 推理,光权重就要 140GB 显存;按我们实际配机器留的余量,单机至少要 160GB 可用。一张 84GB 的卡跑不动,要么两张,要么降到 INT8。**
下面这套算法,是我们给客户做选型时最常用的,可以直接套。
光看权重不够,要按「权重 + KV Cache + 框架开销」三块一起算,最后乘 1.2–1.4 的余量。
| 精度 | 每参数 | 70B 权重 | 14B 权重 | 7B 权重 |
|---|---|---|---|---|
| FP32 | 4 字节 | 280 GB | 56 GB | 28 GB |
| FP16 / BF16 | 2 字节 | 140 GB | 28 GB | 14 GB |
| INT8 | 1 字节 | 70 GB | 14 GB | 7 GB |
| INT4 | 0.5 字节 | 35 GB | 7 GB | 3.5 GB |
按余量系数算出来的实际需求:
| 场景 | 模型 | 建议可用显存 |
|---|---|---|
| 短上下文推理 | 70B FP16 | 170–200 GB |
| 长上下文推理(32K+) | 70B FP16 | 200–240 GB |
| 推理 | 70B INT8 | 85–100 GB |
| 推理 | 14B FP16 | 35–40 GB |
| 单卡本地跑 | 7B INT4 | 6–8 GB |
只算权重就下单,是选型翻车最常见的原因——真实占用里还有两块。
| 组成 | 占比 | 说明 |
|---|---|---|
| 权重 | 最大头 | 参数量 × 每参数字节 |
| KV Cache | 随上下文线性增长 | 长文本场景能超过权重 |
| 框架与碎片 | 5%–15% | CUDA context、算子工作区、碎片 |
我们见过的最典型情况:客户按 140GB 配了两张卡,结果 32K 上下文一开,KV Cache 多吃了 40GB,直接 OOM。
多得多——同一个模型,全参数微调大约是推理的 5–8 倍。
| 方式 | 每参数约 | 70B 需要 |
|---|---|---|
| FP16 推理 | 2–3 字节 | 140–200 GB |
| LoRA 微调 | 4–6 字节 | 280–420 GB |
| QLoRA | 1–2 字节 | 80–120 GB |
| 全参数微调 | 16–20 字节 | 1.1–1.4 TB |
这就是为什么大部分企业客户最后都选 LoRA 或 QLoRA——全参数微调的显存门槛,不是加两张卡能解决的。
先算可用显存,再对照卡型,最后才看算力。
| 可用显存 | 典型组合 | 能跑什么 |
|---|---|---|
| 24 GB | 1 × 24GB | 7B–14B 的 INT4/INT8 推理 |
| 48 GB | 1 × 48GB | 14B–32B FP16 推理 |
| 84–96 GB | 1 × 84GB | 32B FP16、70B INT8 |
| 170 GB+ | 2 × 84GB | 70B FP16 短上下文 |
| 200 GB+ | 4 × 48GB 或 2 × 96GB | 70B FP16 长上下文 |
多卡不是简单相加。 我们配置单里反复见到一个误区:以为 4 张 24GB = 96GB 就能跑 70B INT8。实际上并行效率通常在 40%–70%,卡间互联带宽决定损失多少。
三个,都是我们实际遇到过的。
一、按模型标称参数量算。 同一个 70B 模型,不同量化版本的实际占用能差 30%。要按实际 checkpoint 算。
二、忽略显存带宽。 推理的 token 生成速度受带宽约束。同样 80GB,带宽差一倍,出字速度差一倍。
三、没考虑并发。 并发翻倍,KV Cache 基本也翻倍。单条测出来的数字,不能直接当生产容量。
12GB 显存能跑 14B 模型吗?
能,但只能上 INT4 量化,而且上下文不能太长。14B 的 FP16 权重就要 28GB,12GB 装不下。
只按参数量算够不够?
不够。还要算 KV Cache 和框架开销。长上下文场景下,KV Cache 可能比权重本身还大。
显存和内存是一回事吗?
不是。显存(VRAM)在显卡上,模型权重必须放这里;内存是系统内存,替代不了显存。
多卡能不能线性叠加?
不能。并行效率通常 40%–70%,卡越多损失越大,瓶颈往往是互联带宽。可以看看 显存不够有三条路 里的取舍。
跑的是推理还是微调——两者差 5 倍以上
上下文长度多少——32K 以上的 KV Cache 要单独算
并发多少——并发翻倍,KV Cache 基本翻倍
需不需要 ECC 和长时间稳定运行
未来半年模型会不会升级(留 30% 余量比换卡便宜)
需要按你的模型和场景算一份具体配置,可以联系我们(400-0755-816),把模型和上下文长度说一下,我们回一版配置。
2026-08-21
2026-08-24
2026-08-24
2026-08-25

2026-08-26
2026-08-26
2026-08-27
2026-09-02
2026-09-02
扫码关注