如果你的模型或数据一秒钟都离不开 24GB 显存,直接选 PRO 6000D,别算性价比;如果只跑 14B 以内的推理和图形工作流,5090D 更划算。
九成以上的纠结都卡在同一个点上——24GB 显存边界。
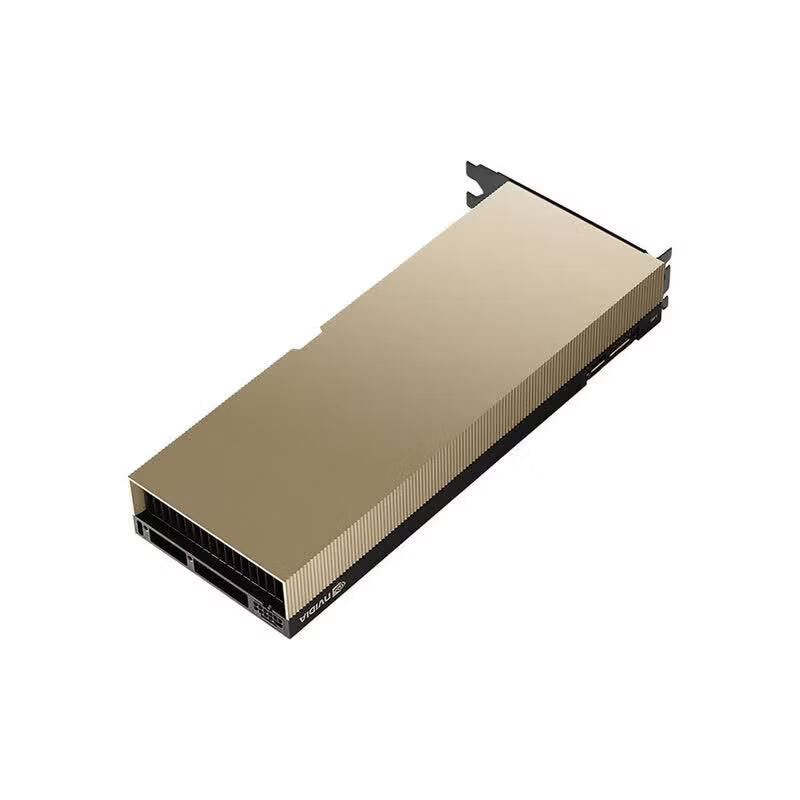
差在显存档位、ECC 和驱动分支,不在算力数字上。
| 项目 | RTX PRO 6000D | RTX 5090D / 5090D V2 |
|---|---|---|
| 显存 | 84GB | 24GB(我们配置单里的版本) |
| 显存类型 | ECC | 非 ECC |
| 驱动分支 | 企业长期支持 | 消费级 |
| 定位 | 专业图形、内容创作、AI 推理、科学计算 | 高性价比算力、图形与游戏 |
| 典型形态 | 工作站 / 服务器单卡 | 工作站、多卡服务器 |
先把最容易被忽略的一条说清楚:ECC。跑长任务的机器,显存位翻转会让计算结果出现不可复现的偏差,做仿真、做训练、跑几天几夜的任务,这个偏差会累积。我们给高校和科研客户配机时,ECC 是硬条件。
够用的场景比想象中多——7B–32B 的量化推理和图形工作流都没问题。
7B–14B 模型的 FP16 推理
14B–32B 的 INT8/INT4 量化推理
Stable Diffusion / ComfyUI 这类图形生成工作流
三维渲染、视频剪辑的 GPU 加速
需要峰值算力但不需要大显存的批处理任务
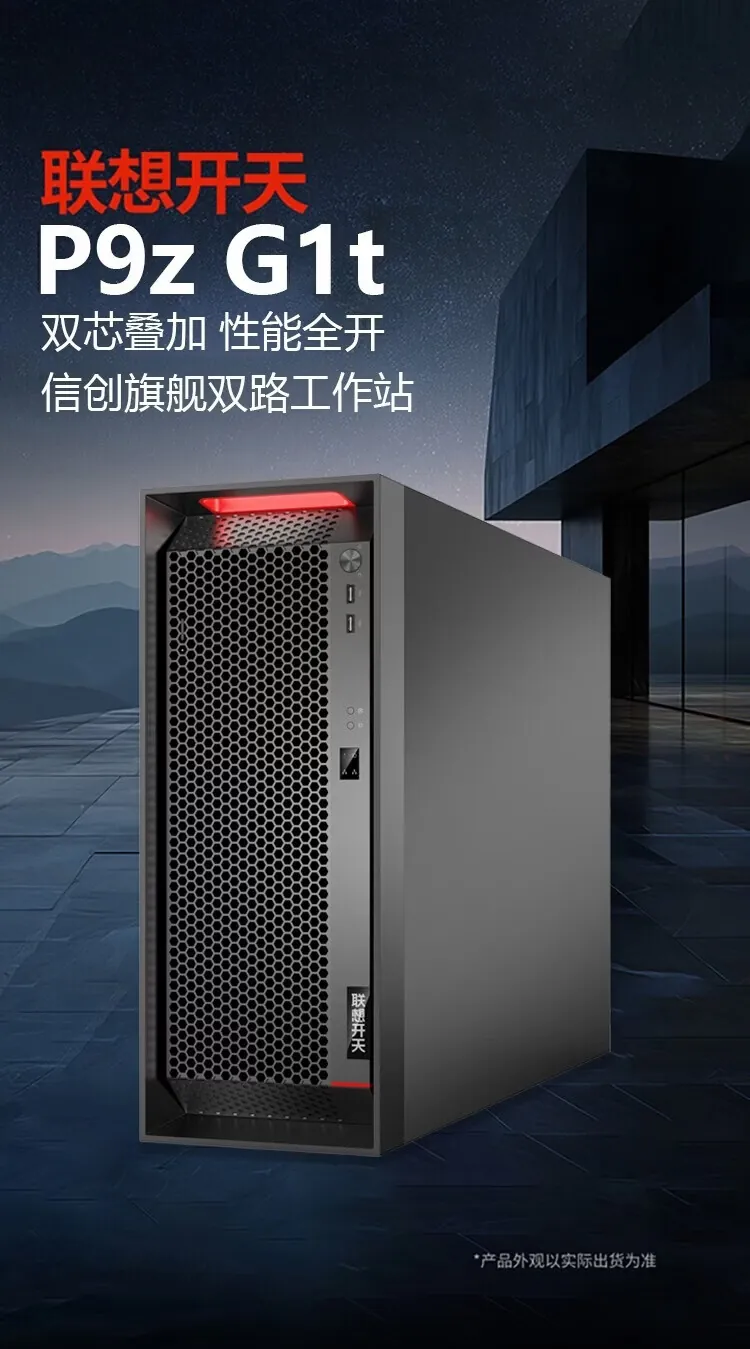
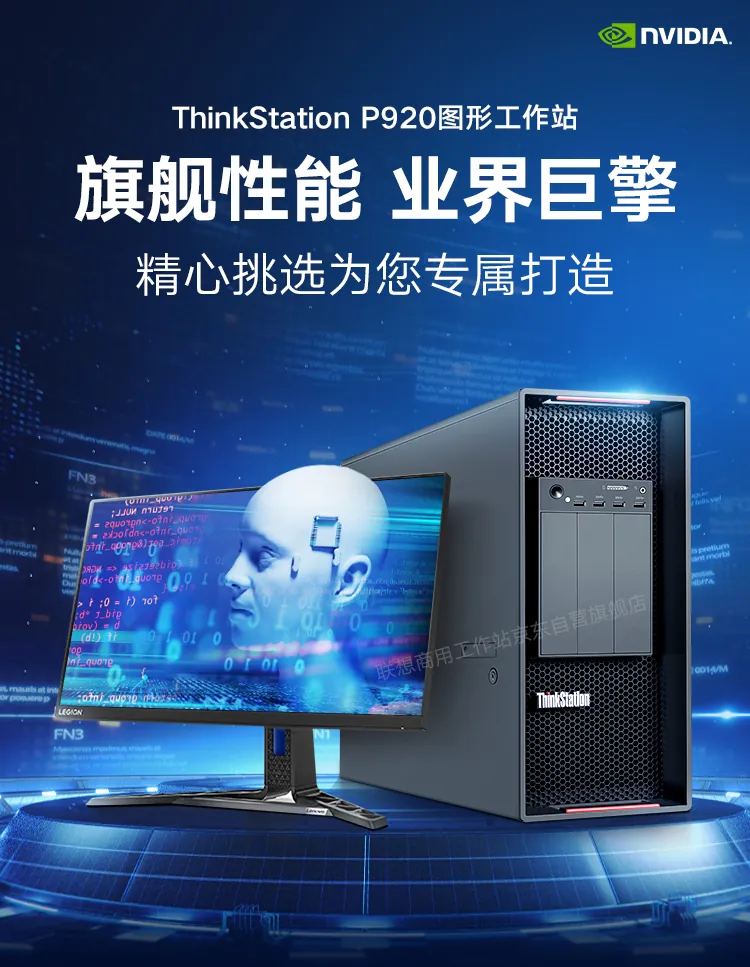
一张 5090D 加一台塔式工作站,跑本地推理和设计工作,成本比专业卡低一大截。
三种情况,省下来的钱会以别的方式还回去。
70B 的 FP16 权重是 140GB,INT8 是 70GB,INT4 是 35GB。24GB 连 INT4 都放不下,只能多卡分片。
我们实测和客户反馈的区间是 40%–70%。三张卡理论上三倍算力,实际可能只发挥 1.2–2 倍。而且分片不是免费的:卡间互联带宽决定损失多少,每张卡要独立放得下自己那份权重和 KV Cache,故障点也变多。
三张 5090D V2 的总功耗约 1725W。这个数字意味着电源要重新算、机箱散热要重新算、机房的供电和制冷也要重新算。很多客户是在这一步才发现预算不对。
不能简单对比——一个是连续显存,一个是分散显存。
| 维度 | 1 × PRO 6000D(84GB) | 3 × 5090D V2(72GB 名义) |
|---|---|---|
| 可用显存 | 84GB,单卡连续 | 72GB,分散在三张卡 |
| 70B INT8 推理 | 可以(接近上限) | 需要分片,效率打折 |
| 70B FP16 推理 | 不行 | 不行 |
| 峰值算力 | 低于三卡 | 更高 |
| 总功耗 | 低 | 约 1725W |
| 稳定性 | ECC + 企业驱动 | 非 ECC + 消费驱动 |
这不是「谁的算力高」的对比,是「你要连续显存还是要峰值算力」的选择。
给客户做选型时,我们用这三条来分。
选 PRO 6000D 的情况:模型或数据规模会越过 24GB;需要 7×24 长时间跑,不能容忍结果偏差;科研、仿真、金融这类对可复现性有要求的场景;机房里不想为散热和供电再做一次改造。
选 5090D 的情况:模型稳定在 14B 以内,或者只做量化推理;图形、渲染、视频这类工作流为主;有多卡机箱和充足供电余量。
两种都不合适的情况:要跑 70B FP16,直接上两张 84GB;要做全参数微调,显存需求是 TB 级,得上服务器平台。
两张卡最本质的区别是什么?
显存档位和 ECC。6000D 是 84GB 带 ECC,5090D 系列在我们配置单里是 24GB、不带 ECC。
6000D 属于什么档次?
专业卡阵营,位于专业工作站和服务器之间,不是消费级游戏卡。
单张 6000D 能跑 70B 模型吗?
INT8 量化可以,接近 84GB 上限;FP16 不行,权重就要 140GB。
三张 5090D 能替代一张 6000D 吗?
算力上可能超过,但显存是分散的,跑大模型要分片,并行效率打四到七折,而且总功耗到 1725W。
模型最大显存占用是多少(不是参数量,是实际占用)
上下文长度和并发——这两个决定 KV Cache
机房单机柜能提供多少电
需不需要 ECC 和企业级驱动
想按你的模型和预算算一版具体配置,可以联系我们(400-0755-816),说明用途和显存需求即可。
2026-08-21
2026-08-24
2026-08-24
2026-08-25

2026-08-26
2026-08-26
2026-08-27
2026-09-02
2026-09-02
扫码关注