MiniMax H3 本地部署能不能成立,判断顺序只有一条:先看显存装不装得下你要同时挂的模型,再看卡间带宽与系统内存撑不撑得住目标并发,最后才轮到机房供电和预算。三条是串联的,前一条不过,后面全白算。本文比同类内容多给的是方法:把「显存够不够」和「并发扛不扛得住」拆成两个你能拿计算器自己验算的口径,而不是塞一个整机型号让你照着买。
云端年费只能说明你为调用量付了多少钱,说明不了你需要多少显存,这两件事之间没有换算关系。
常被引用的说法是「一条 10 秒视频走云端,一年最少 60 多万」。这个数没交代是哪个平台、什么分辨率、单次时长上限多少、含不含存储与出网流量,也没交代币种,我按未核实处理。即便数字成立,它衡量的也是累计调用量;本地硬件买的是峰值能力。你的业务里最贵的是峰值那一刻——同一时间涌进来多少条请求,决定了要插几张卡,而不是一年跑了多少条。
真正的比法是把三个数拉出来:年调用总量、单次生成时长、峰值并发数。前两个算云端账,第三个算本地账,两个账本对不上是常态。
所以往下走,得先把「显存够不够」这件事的口径定死。
MiniMax H3 要多少显存,取决于你同时挂几个模型、每个模型留多少并发,不是参数量乘一个系数就完事。
权重占用 = 参数量 × 精度字节数。FP16 按 2 字节、FP8 按 1 字节、INT4 量化大致按 0.5 字节估算。全模态模型意味着文本、图像、视频、音频几套权重可能同时驻留,要相加而不是取最大。这一步算出来的是下限,不是答案。
每多一路并发,就要多留一份 KV cache;视频生成还要额外的帧缓存与中间张量。序列越长、分辨率越高,单路占用越大。这一项最容易被漏掉,也是「单机能跑」和「单机能扛并发」的分界线。
框架开销、显存碎片、长时间运行的泄漏累积,都要吃余量。我的做法是按可用显存的 15%–20% 预留,宁可少挂一个模型。反例很常见:按标称显存把每个模型算到刚好装下,第一批并发上来就 OOM,然后回头怀疑卡有问题。
| 维度 | 判断口径 | 常见误配 | 验收方法 |
|---|---|---|---|
| 显存总量 | 权重 + KV cache + 15%–20% 余量,多模型相加 | 按标称显存算到刚好装下 | 全模型加载后跑满目标并发,看剩余显存 |
| 单卡容量 | 整机显存 ÷ 卡数,逐卡核对规格书 | 只信整机总数,不看单卡 | 厂商规格书比对 + 到货后用 nvidia-smi 核对 |
| 卡间与主机带宽 | 模型分片、多卡并行是否需要高带宽互联 | 8 张卡当 8 张独卡用 | 压测看扩展效率,不看单卡跑分 |
| 系统内存 | 装得下模型文件、预处理与多进程 | 只算显存不算内存 | 加载峰值的 free -g 曲线 |
| 供电与散热 | 卡数 × 单卡 TDP + CPU/内存/风扇余量 | 按整机标称功率配 UPS | 功率计实测 + 满载 30 分钟温升 |
| 机房条件 | 机柜承重、风道、进风温度 | 只算设备钱 | 现场勘查记录留档 |
表里六行是串联的,不是并列的:显存那一行不过,后面五项都没有意义。
672GB 整机显存能同时跑几个模型,取决于你怎么切分,不是卡插满就好。
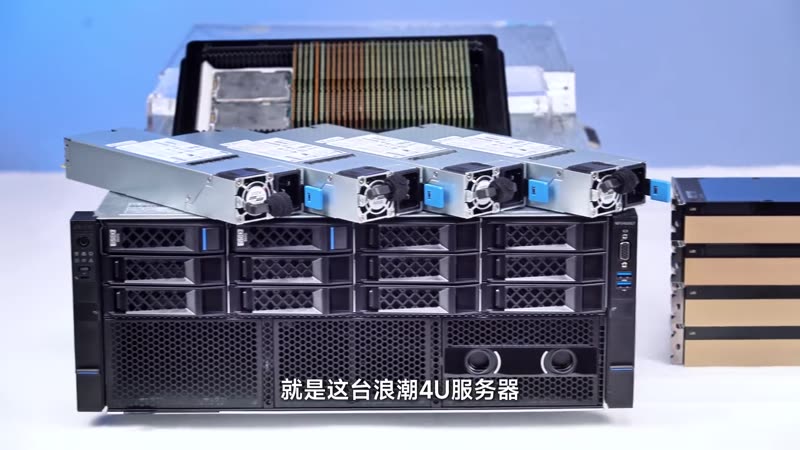
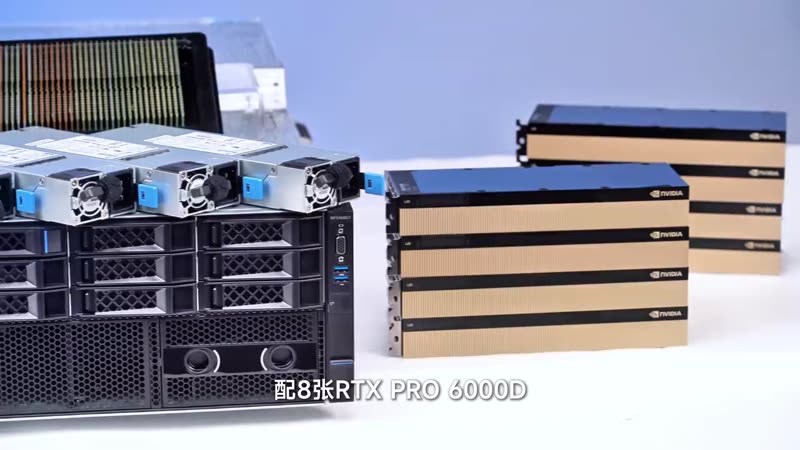
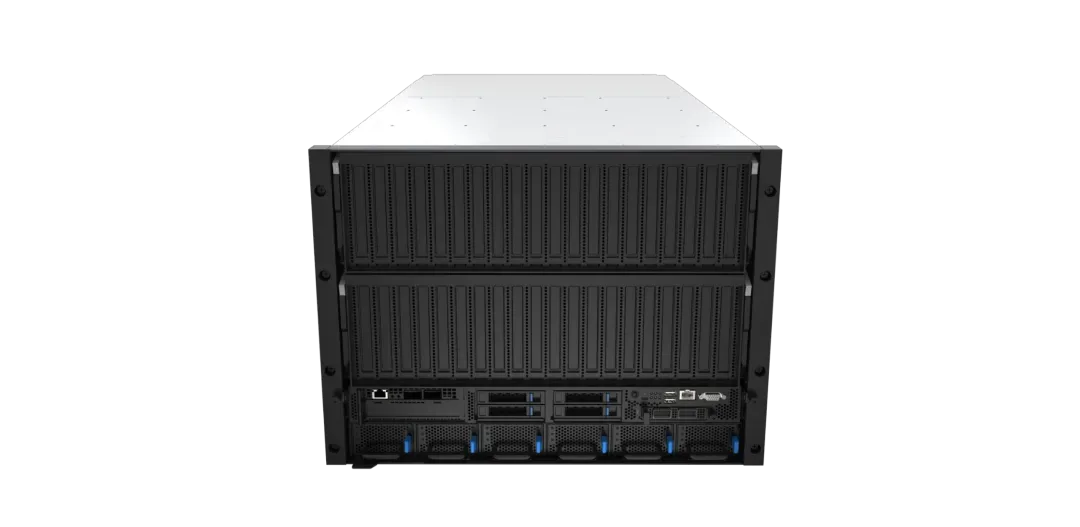
商红科技给的配置是浪潮 4U 服务器配 8 张 RTX PRO 6000D,整机显存 672GB,配 DDR5 内存。按 672 ÷ 8 反推,单卡约 84GB——这个数字必须在下单前用厂商规格书逐卡核对,同一型号的不同后缀版本与不同供货批次,单卡容量会变,整机总数对不上单卡数是最常见的报价纠纷来源。
分显存我按三步走。先扣 15% 余量,672GB 大约剩 570GB 可用。再把几套权重按实际调用频率排优先级,高频的常驻、低频的按需加载。剩下的才是 KV cache 与并行实例的空间。8 张卡的正确用法不是全卡跑同一个模型,而是分组:文本与图像一组、视频一组、音频一组,各组独立扩并发,这样才能做到几个模型同步并行、高并发推理不互相拖。
同是 4U 平台的 浪潮英政 CS5468H3 服务器规格与适用场景 走的是海光处理器路线,询价时建议一起拉出来做平台对照,看清楚 GPU 直通、供电余量与风道设计的差别。
配置定完,还有一半工作没做:这套东西在你自己业务上到底能跑多少并发,规格书答不了。
月调用量低、峰值不集中的团队,做本地部署不划算。
设备只是账面上的一项。8 卡整机的配电改造、UPS、机柜承重加固、机房散热、日常运维人力,都不在设备报价里,且这些钱花下去不会因为你调用量变小而变少。三类情况我建议直接放弃本地路线:
一是调用量小且峰值平缓,云端按量付费更便宜,省下的钱拿去做模型调优更值。二是模型迭代快、显存需求一路涨的团队,硬件两年内可能就吃不下新模型的权重,除非你能接受两年一换。三是需要多地域低延迟响应的业务,单机放在一个机房解决不了。
还有三条必须说清楚:这台配置在你业务上的实际吞吐,只有压测能证明,规格书和我这里的推算都不能;云端的年费和本地硬件的折旧年限不匹配时,任何 ROI 数字都是凑出来的,我不接这种算法;量化到 INT4 能省显存,但对生成质量的损失要在你自己的业务样本上测,不能默认可接受。
取决于你要保留几路并发。先把四类模型的权重相加,再按 15%–20% 留余量,剩下的除单路 KV cache 与帧缓存占用,就是并发上限。如果只要求每类各跑一路、并发个位数,这套配置有余量;如果视频生成要同时跑十几路高分辨率,先做压测再谈够不够。
取决于你的峰值并发和调用单价,不取决于年调用总量。判断口径是:把云端的年费减去电费与运维人力,再除以设备折旧年限,得到的数与整机报价比。调用量低、峰值平缓的项目,这个数通常算不过来,不必勉强。
不一定。8 卡整机的功耗按卡数 × 单卡 TDP 加上 CPU、内存、风扇余量估算,具体 TDP 以厂商规格书为准,再对照机柜的配电容量、UPS 余量和进风温度。很多机房的瓶颈不是电力总量,是单路 breaker 与机柜内风道。
取决于接口对齐的程度。如果沿用模型原生的推理接口,主要是环境与权重加载的调试;如果已有业务系统要对接,改造工作量在接入层而不在模型层。周期我会按「到货上架 → 环境与权重 → 单机压测 → 业务联调」四段报,不给一个笼统的总天数。
先看显存口径,再看并发与带宽,最后才比价格——顺序反了,省下来的钱会在压测那天还回去。
边界也放这儿:本文给的是算法与验收口径,不是对你业务的吞吐承诺;单卡容量、整机功耗这类硬件参数,一律以厂商规格书和到货实测为准。
下一步最省事的做法,是把你手上那份模型清单和峰值并发数拿出来,按上面那张表逐行填一遍,填不满的那一行就是你要问供应商的第一个问题。
全国统一服务热线:400-0755-816,把项目类型、模型清单和目标并发发给我们,获取一份按显存口径算过的配置建议。
也可以直接联系商红科技,说明现有服务器与机房条件,由工程师按你的清单出对照方案。
延伸阅读
2026-08-21
2026-08-24
2026-08-24
2026-08-25

2026-08-26
2026-08-26
2026-08-27
2026-09-02
2026-09-02
扫码关注