一句话结论:AI 漫剧要在自己机房里跑,显存不用一步到 40G 以上,但 12GB 这一档跑不满 15 秒以上的长镜头。商红科技交付的英特尔® 锐炫™ 专业版 B70(32GB)方案,在 MiniMax H3 上的自测结果是:5 秒镜头 5.61 条/小时、10 秒 2.01 条/小时、15 秒 1.02 条/小时;同条件下一张 12GB 卡在 15 秒镜头掉到 0.53 条/小时。选型的分水岭不是显存够不够大,而是你的镜头时长分布落在哪一段。
AI 漫剧这类内容,单集一到三分钟,靠几十个短镜头拼出来。做的过程不像"点一下出一段成片",更像一条产线:同一个角色、同一套画风,反复生成、反复挑、反复改。这种活儿对算力有两个很具体的要求——能不能连续跑,和素材能不能不出门。前者是显存与调度的账,后者是合规的账。商红科技基于英特尔锐炫专业版 B70 显卡做的本地方案,就是为这两笔账准备的。
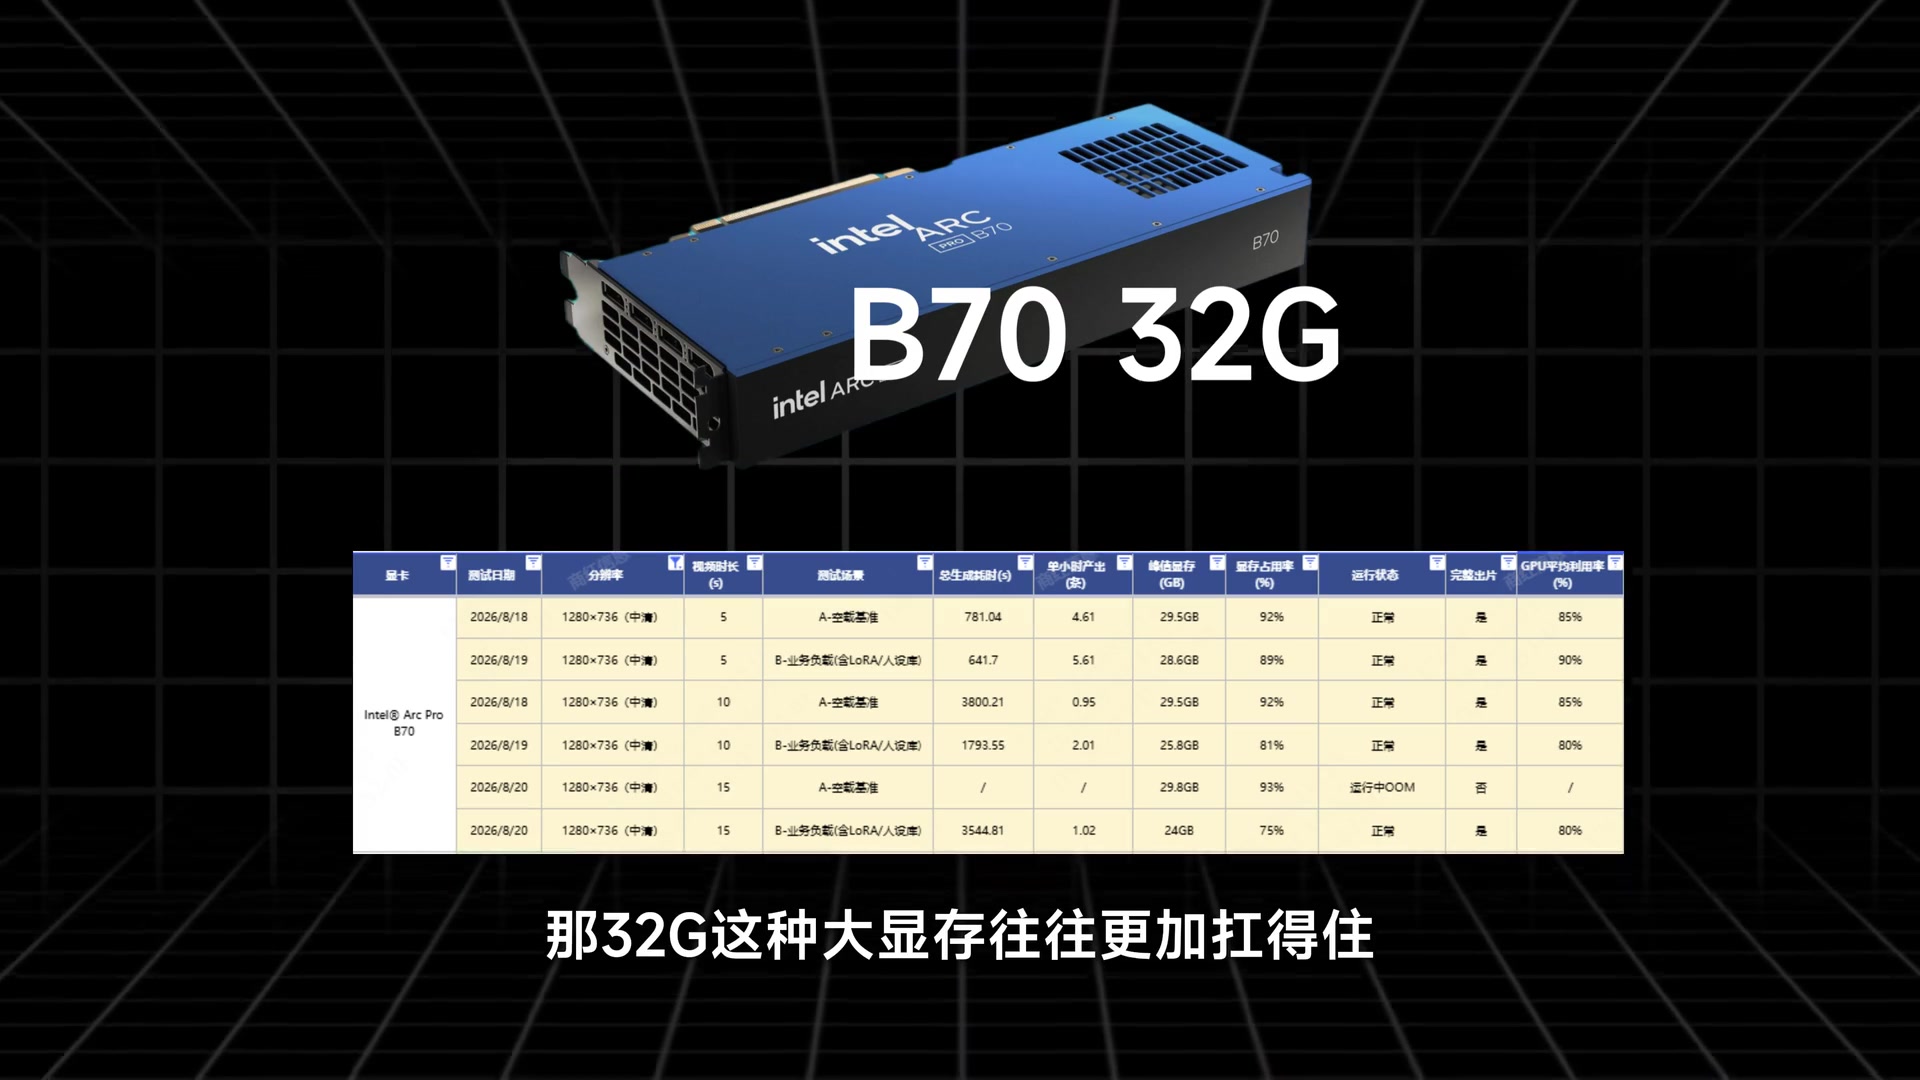
商红科技实验室自测:英特尔锐炫 Pro B70 32GB 跑 MiniMax H3,1280×736 分辨率下 5 / 10 / 15 秒三档镜头的完整记录。
因为拖住漫剧产能的往往不是创意,而是三件确定性的事情:单条镜头要改十几版、素材和未公开成片不能出内网、生成量一上来按次计费的成本不可控。本地生成把这三件事一次性解决——算力在自己的机器里,迭代不用排队,成本在买断那天就基本定型。
云端不是不能用。真做起来,很多团队是两条腿走:粗筛、试风格在云端图快,定稿、批量出片在本地。区别在于本地这条腿得有足够的显存余量和稳定的驱动环境,否则每次生成都像在赌这一版会不会崩。
漫剧的镜头普遍短,三秒到十几秒一段。这一点很关键——镜头时长直接决定显存和吞吐落在哪一档,后面的实测数据会把这个关系摆清楚。
它是 32GB 显存的专业卡,价值落在三处:装得下量化后的视频模型、同时管住生成与剪辑、显存余量够撑长镜头。
软件栈走 SYCL / oneAPI,配 OpenVINO 和 Intel Extension for PyTorch 做本地推理,也能对接 ComfyUI、vLLM、Docker 这些常用环境。
| 项目 | 英特尔® 锐炫™ 专业版 B70 |
|---|---|
| 显存 | 32GB GDDR6 |
| 显存位宽 / 带宽 | 256bit / 608 GB/s |
| 计算单元 | 32 个 Xe 核心、256 个 XMX 引擎 |
| INT8 算力 | 367 TOPS |
| 编解码 | 双路硬件编解码,支持 8K@120Hz、HDR |
| 剪辑能力 | 可流畅剪辑 10 轨以上 4K |
| 已适配创作软件 | 剪映、DaVinci Resolve、Premiere Pro、Photoshop |
| 软件栈 | SYCL / oneAPI(非 CUDA);支持 OpenVINO、Intel Extension for PyTorch;可对接 vLLM / ComfyUI / Docker |
32GB 的用处不止"塞模型"。视频生成的过程里,模型权重只占一部分,剩下的被激活值、VAE 解码、帧缓存吃掉——这也是为什么很多 12GB、16GB 的卡在短镜头上表现很好,镜头一长就开始掉速甚至报错。显存余量买的是"长镜头能不能跑完",不是"跑分高不高"。
生成完不用倒素材,是本机的第二个好处。双路硬编解码加上 10 轨以上 4K 的剪辑能力,意味着一台机器能同时承担"生成—粗剪—调色—出片",中间不用在两台设备之间来回拷。
结论先给:5 秒镜头 12GB 卡更跟手,10 秒打平,15 秒 32GB 反超接近一倍。
下面这组对照来自商红科技实验室,模型 MiniMax H3,分辨率 1280×736(中清);A 为空载基准,B 为业务负载(带 LoRA 与人设库,也就是真实漫剧项目的样子)。
| 视频时长 / 场景 | 锐炫 Pro B70 32G 总耗时 | 单小时产出 | 12GB 对照卡 总耗时 | 单小时产出 |
|---|---|---|---|---|
| 5 秒 / B-业务负载 | 641.70s | 5.61 条 | 555.39s | 6.48 条 |
| 10 秒 / B-业务负载 | 1793.55s | 2.01 条 | 1757.97s | 2.05 条 |
| 15 秒 / B-业务负载 | 3544.81s | 1.02 条 | 6746.51s | 0.53 条 |
| 15 秒 / A-空载基准 | 运行中 OOM | — | 9953.48s | 0.36 条 |
(数据来源:商红科技实验室自测,2026/8/18–8/25,MiniMax H3,1280×736。表内为原始记录,对比结论为按表推算。)
三个数字背后的差别,在显存占用率上:32GB 卡的峰值显存在 24.0–29.8GB 之间,占用率 75%–93%;12GB 卡全程 10.8–11.6GB,占用率 90%–97%。12GB 卡是一直贴着天花板跑的,短镜头时这叫调度效率高,长镜头时就变成没有退路——15 秒空载基准那一组,它花了 9953 秒才出一条,单小时产出 0.36 条。
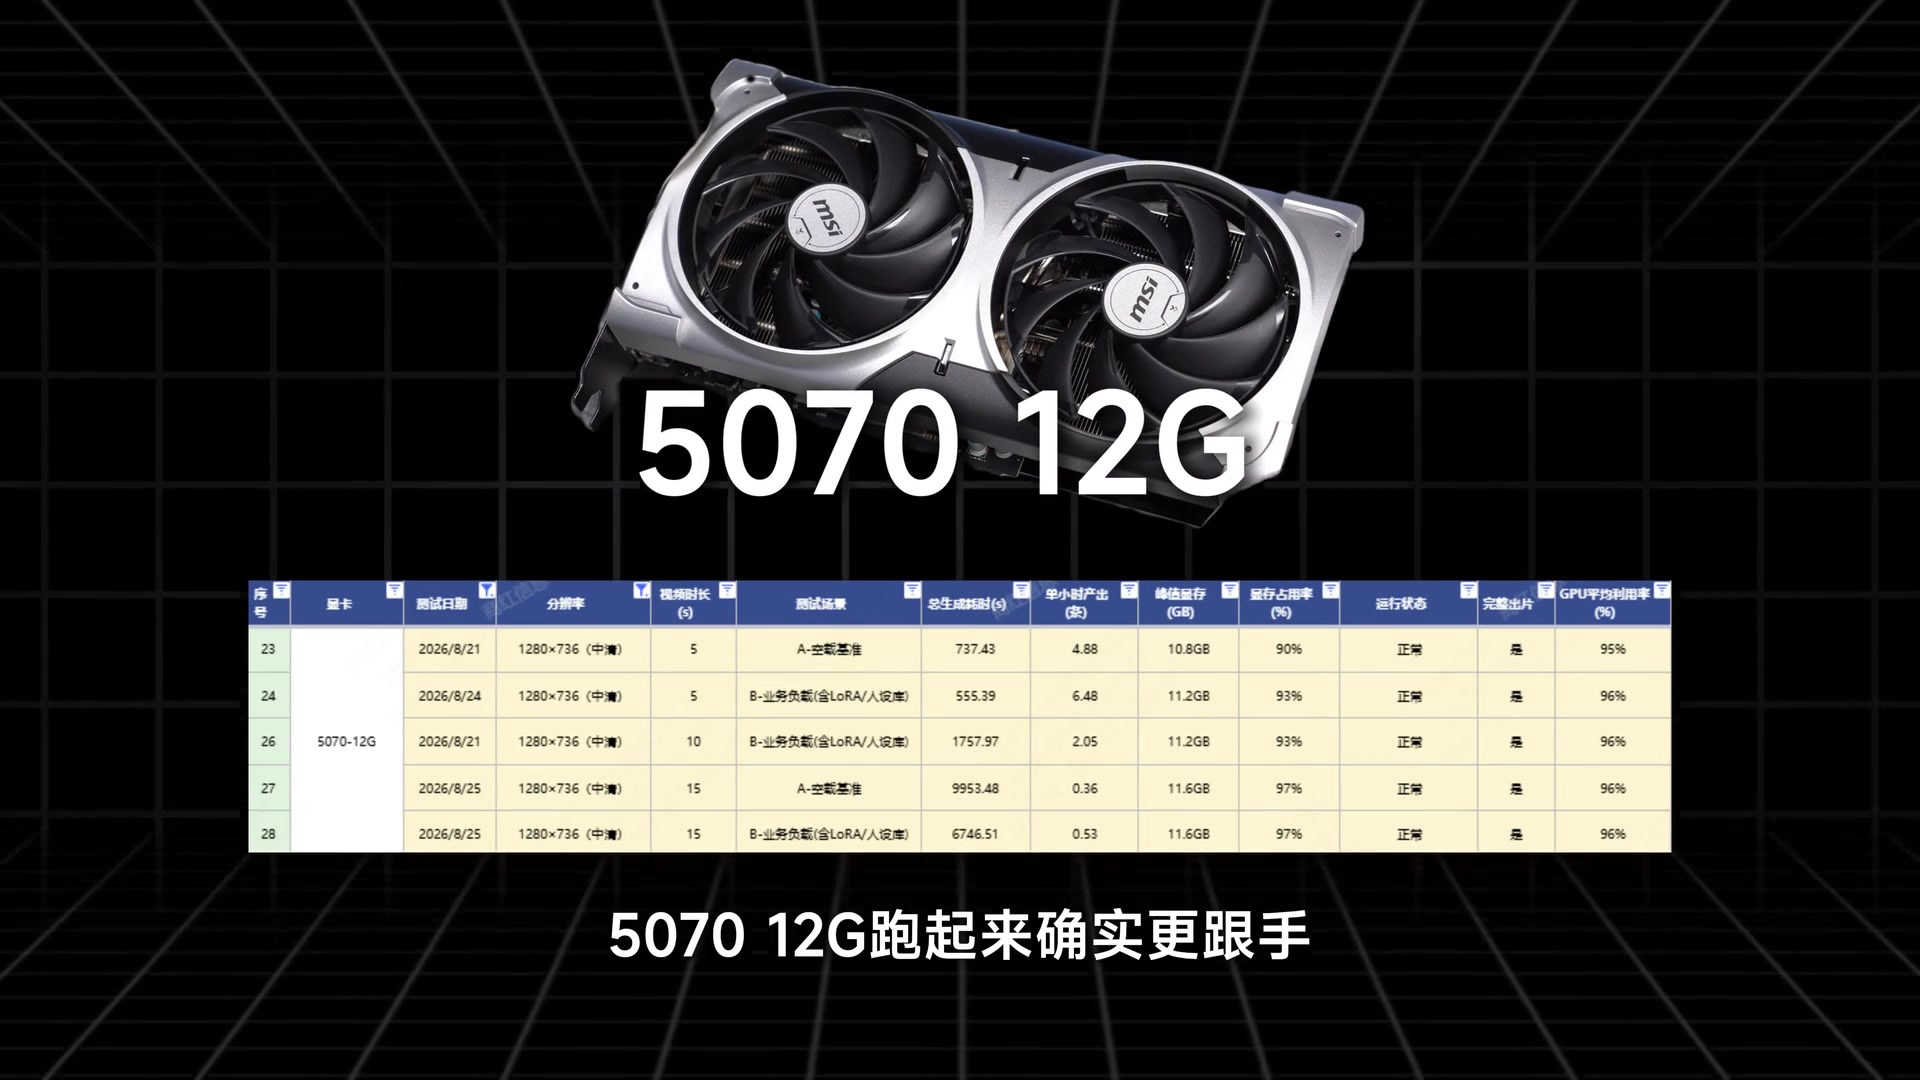
对照组:12GB 显存卡在同样条件下的记录。显存占用率长期落在 93%–97%,长镜头吞吐明显下滑。
所以"做 AI 漫剧该买多大显存的卡"这个问题,答案取决于你自己的镜头表:如果全片都是三到五秒的快切,12GB 完全够用而且更快;只要片子里有相当比例 10 秒以上的运镜、长镜、连续动作,32GB 才是那个不会中途卡住的档位。
显卡只是方案的一半,另一半是平台能不能长期扛住。商红科技的做法是按产线规模配三档,从"验证值不值"到"稳定量产"再到"该上服务器了"。
| 档位 | 适用情况 | 建议配置方向 | 结果预期 |
|---|---|---|---|
| 验证档 | 先跑通链路,判断本地是否适合自己 | 单张锐炫 Pro B70 32GB + 消费级/工作站级双宽塔式平台 | 覆盖 5–15 秒镜头的完整链路,先看画质和等待时间能不能接受 |
| 量产档 | 每天稳定出片,生成与剪辑并行 | 单卡 B70 承担生成,整机侧留足 DDR5 内存与高速存储;或双卡拆分生成与超分/渲染 | 5 秒镜头 5.6 条/小时量级,长镜头不掉线 |
| 集群档 | 并发多人、每天几十上百条成片 | 转向多卡服务器与调度队列,工作站不再是瓶颈 | 单机吞吐已到上限,该按集群规划 |
配套的平台侧参数,从整机方案看主要落在这几项:第二代英特尔酷睿 Ultra 9 级处理器、DDR5 内存最高 256GB、风冷或液冷可选、1.2mm 加厚板材的加固结构,双宽专业卡可扩展。内存这一项容易被忽略——视频生成会大量调用系统内存做 offload,内存不够时,再好的卡也会被拖慢。
最要紧的一条先说:15 秒空载基准那一组 OOM 了,峰值显存 29.8GB、占用 93%。
同一张卡在带 LoRA 的业务负载下反而正常跑完(24GB、75%)——说明能不能跑通,取决于模型的量化方式、分辨率、批次大小和显存分配策略,不是"显存大就一定行"。这也解释了为什么这个方案要由人配:参数不对,32GB 也会崩。
第二条,它是 SYCL / oneAPI 生态,不是 CUDA。团队里已经攒了一堆 CUDA 脚本、自定义算子、私有推理框架的,迁移是有成本的。反过来说,如果你的技术栈本来就在 OpenVINO、ComfyUI 这一侧,接进来反而顺。
第三条,本地画质有模型侧的天花板。H3 这套系统里,开源的只有生成那一段,本地输出是 768P 级加原生立体声,要原生 2K 得靠超分或者走托管接口。指望"本地直出 2K 长片"的,这一档满足不了。
第四条,它不适合偶尔出片的人。一个月出三五条、不涉及保密素材,云端 API 更省事也省钱。本地工作站的账,要按"每天都跑、跑一年"来算才成立。
交付的不只是一张卡,还有从选型到售后的一条链。
商红科技作为联想核心合作伙伴,做的是从前期咨询、硬件交付、部署调优到长期运维:先看你的镜头表和生产节奏,判断该单卡还是双卡;再把显卡、平台、内存、存储在整机侧配对;然后装驱动、配推理环境、把模型跑通;交付后负责版本更新和故障兜底。
这也解释了为什么"自己买卡装机"和"买方案"是两件事:装得上不难,难的是三个月后新模型开源时谁来适配、崩了谁来兜底、连续跑一周稳不稳。生态侧的适配速度可以看一个公开例子——万相 Wan-Animate-2 开源当天,锐炫 B70 就完成了 Day 0 端到端适配;经 ComfyUI 节点侧优化后,FP16 与 BF16 精度下推理性能分别提升 13.1% 和 14.5%(英特尔口径)。这类适配落到具体一台机器上,需要有人做完最后一段。
想先看看这套东西在自己项目里是什么样,最省事的办法是带着一段真实素材和几组提示词来跑一轮:看画质、看一轮生成的等待时间、看显存有没有顶到上限。跑完这一轮,该买单卡还是双卡、要不要上双卡拆分超分,账自己就清楚了。
Q1:做 AI 漫剧,一张 32GB 的 B70 够用吗?先单卡还是直接上双卡?
按商红科技自测,1280×736 分辨率下,5 秒镜头约 5.61 条/小时、10 秒约 2.01 条/小时、15 秒约 1.02 条/小时,三档都能完整出片。够不够用取决于镜头时长分布和每天出片量。配置上先用单卡把链路跑通、验证画质和节奏能不能接受,再决定要不要双卡拆生成与超分——一上来就配双卡,容易在没搞清需求之前把钱花在错的地方。
Q2:为什么 15 秒镜头在 32GB 卡上反而报 OOM?
实测里 15 秒空载基准峰值显存到 29.8GB、占用 93%,运行中溢出;同一张卡在带 LoRA 的业务负载下占用 24GB、正常出片。显存占用和模型量化方式、分辨率、批次、调度策略强相关,参数需要针对项目调,这正是方案交付要做的部分。
Q3:这张卡能跑别的模型吗,只能跑 MiniMax H3?
不止。它支持 OpenVINO、Intel Extension for PyTorch,可对接 vLLM、ComfyUI、Docker,量化后的主流开源模型都能跑。漫剧常用的图生视频、角色动画、超分、口型这几类模型,是这套方案重点适配的方向。
Q4:本地做和云端做,成本到底怎么比?
本地是一次买断加电费,量越大边际成本越低,且素材不出内网;云端按条/按秒计费,起量快但成本随量线性上涨。判断标准只有一条:你的素材和未公开成片能不能离开内网。能,云端更省心;不能,本地是唯一合规选项。
延伸阅读:联想 ThinkStation PX 本地部署大模型|MiniMax H3 开源:8 卡 NF5468M7 撑起本地视频生成整条产线|RTX Pro 系列专业显卡选型指南
想把上面这轮实测在你自己的项目上复现一遍,或者要一份按你的镜头表算过的配置清单,可以联系我们,也可以直接看产品中心里对应的整机与显卡组合。咨询热线 400-0755-816。
2026-10-22

2026-10-22
2026-10-22
2026-10-22
2026-10-22
2026-10-22
2026-10-14
2026-10-14
2026-10-14
扫码关注



