一句话结论:同一套模型、同一个框架、同样的 16:9 输出下,锐炫 Pro B70 32G 在 8 个可测档位里拿到 1 个第一(1080P/5s,7.42 条/小时)、4 个第二、2 个第三、1 个第四,没有一个档位掉出前四;而显存只有 12G / 16G 的消费级卡,产能只有它的 3%–66%。对 AI 漫剧这种"短镜头、要批量、要反复改"的产线,32G 这一档是能不能接高清订单的分界线。
AI 漫剧的产能问题,最后都落在两个数字上:一小时能出几条,以及这条产能能不能对客户承诺。商红科技把这两个问题做成了可查的东西——10 张显卡、146 条测试记录,同一个模型、同一个框架、同样的输出比例,覆盖低清/中清/1080P 三档分辨率和 5/10/15 秒三档镜头时长,并按"显存占用 + 能否完整出片 + 能否重复运行"给每条记录定了级。
下面是这批数据里与选型直接相关的部分。
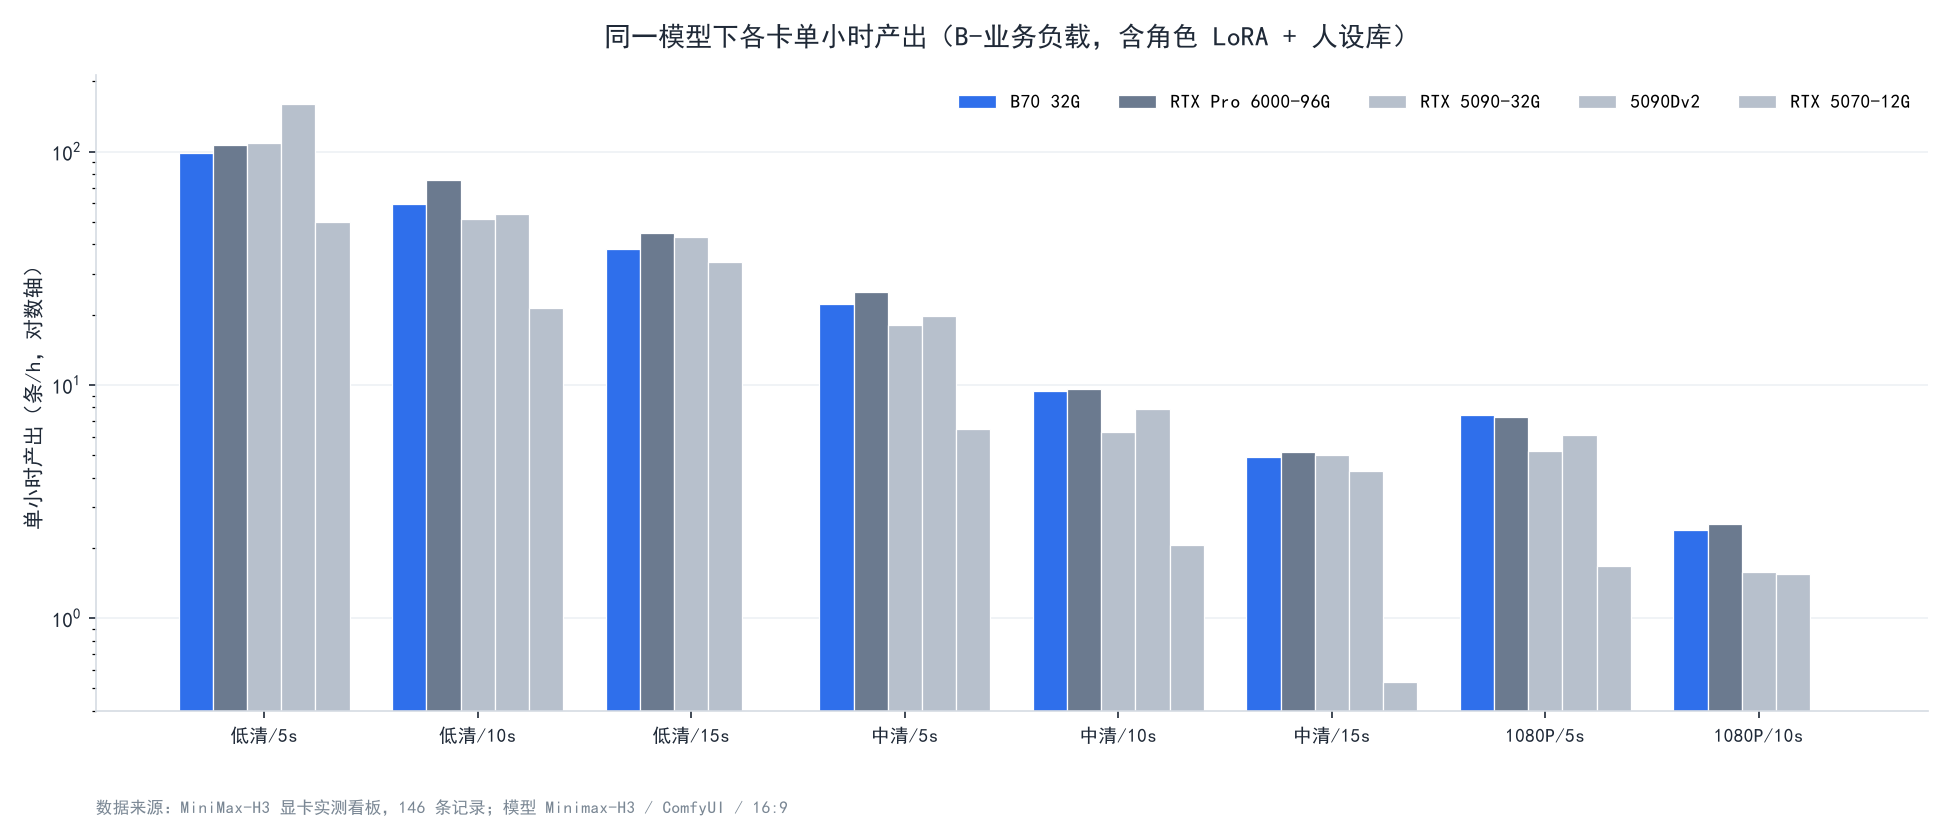
同一模型下的单小时产出对比(B-业务负载:含角色 LoRA + 人设库)。纵轴为对数刻度,便于同时看清高产能档与低产能档的差距。
条件全部固定:模型 Minimax-H3、框架 ComfyUI、输出 16:9,共 146 条有效记录。
模型组件是 Unet-int8 + Qwen3VL-32B-AWQ + H3-VAE + Audio-VAE,覆盖低清 / 中清 / 1080P 三档分辨率、5 / 10 / 15 秒三档时长、两类场景。场景的区别很关键:
A - 空载基准:裸模型单任务串行,不加载 LoRA、人设库、风格插件,也不许其他程序占 GPU。测的是硬件理论上限。
B - 业务负载:加载角色 LoRA + 人设库,模拟漫剧工作室真实生产环境,可叠加多任务排队。对外报数一律用这一档。
本文所有产能数字都是 B 档。另外要说明一句:A 档和 B 档的测试不在同一批次,源表没有记录两组是否使用同一量化版本与采样步数,所以两组之间不做横向比较,只各自纵向看档位差异。
按单小时产出排序,B70 在 8 个有数据的档位里:1080P/5s 第一,低清/10s、中清/5s、中清/10s、1080P/10s 四个第二,低清/15s、中清/15s 两个第三,低清/5s 第四。
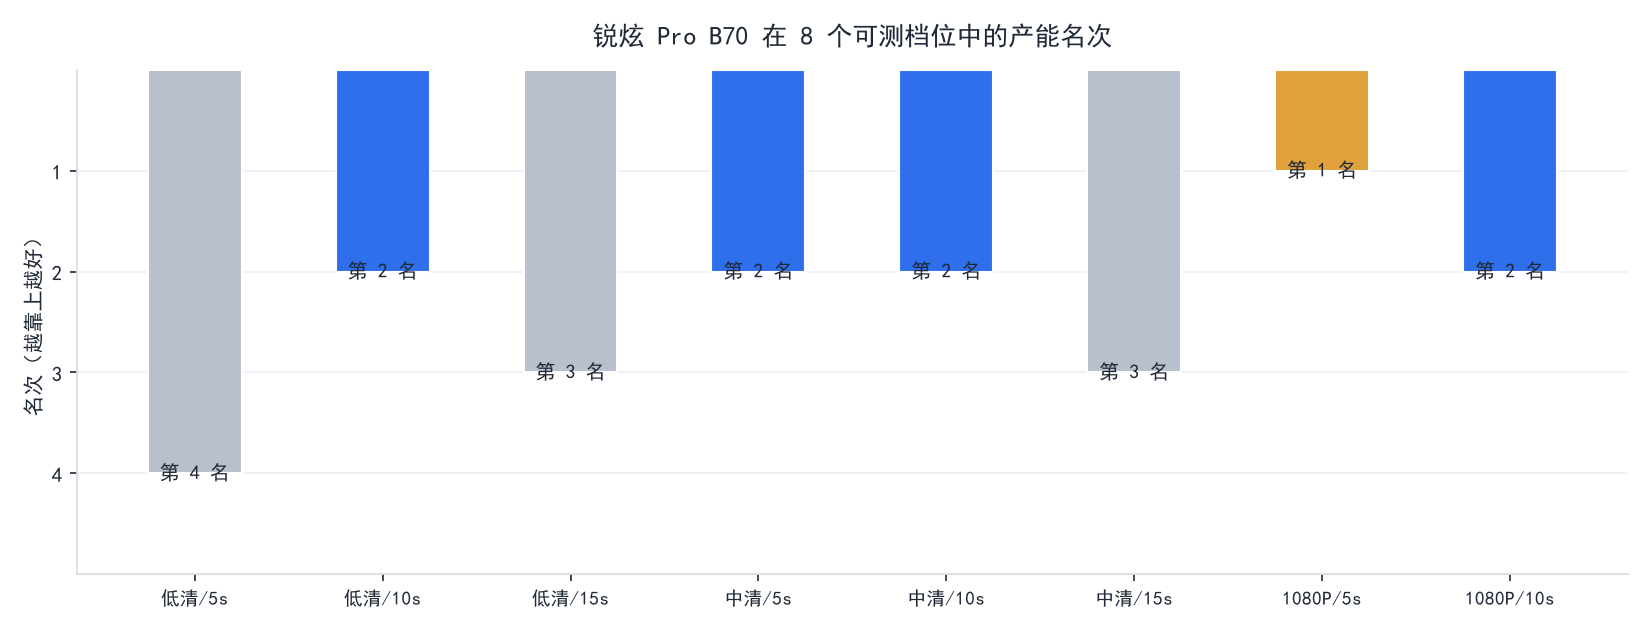
按"单小时产出(条/h)"排序的名次。B70 全部 8 个档位都在前四,1080P/5s 档位为第一。
具体数字是这样的(B 档,条/小时):
| 档位 | 冠军 | 冠军产能 | B70 产能 | B70 名次 | 参与排序卡数 |
|---|---|---|---|---|---|
| 低清 / 5s | 5090Dv2 | 160.07 | 98.40 | 第 4 | 10 |
| 低清 / 10s | RTX Pro 6000-96G | 75.65 | 59.56 | 第 2 | 10 |
| 低清 / 15s | RTX Pro 6000-96G | 44.96 | 38.17 | 第 3 | 8 |
| 中清 / 5s | RTX Pro 6000-96G | 24.89 | 22.22 | 第 2 | 9 |
| 中清 / 10s | RTX Pro 6000-96G | 9.61 | 9.41 | 第 2 | 9 |
| 中清 / 15s | RTX Pro 6000-96G | 5.15 | 4.93 | 第 3 | 9 |
| 1080P / 5s | B70 32G | 7.42 | 7.42 | 第 1 | 9 |
| 1080P / 10s | RTX Pro 6000-96G | 2.54 | 2.39 | 第 2 | 8 |
(1080P/15s 这一档 10 张卡都没有数据,源表里 20 秒以上的行是公式预留,实际没测。)
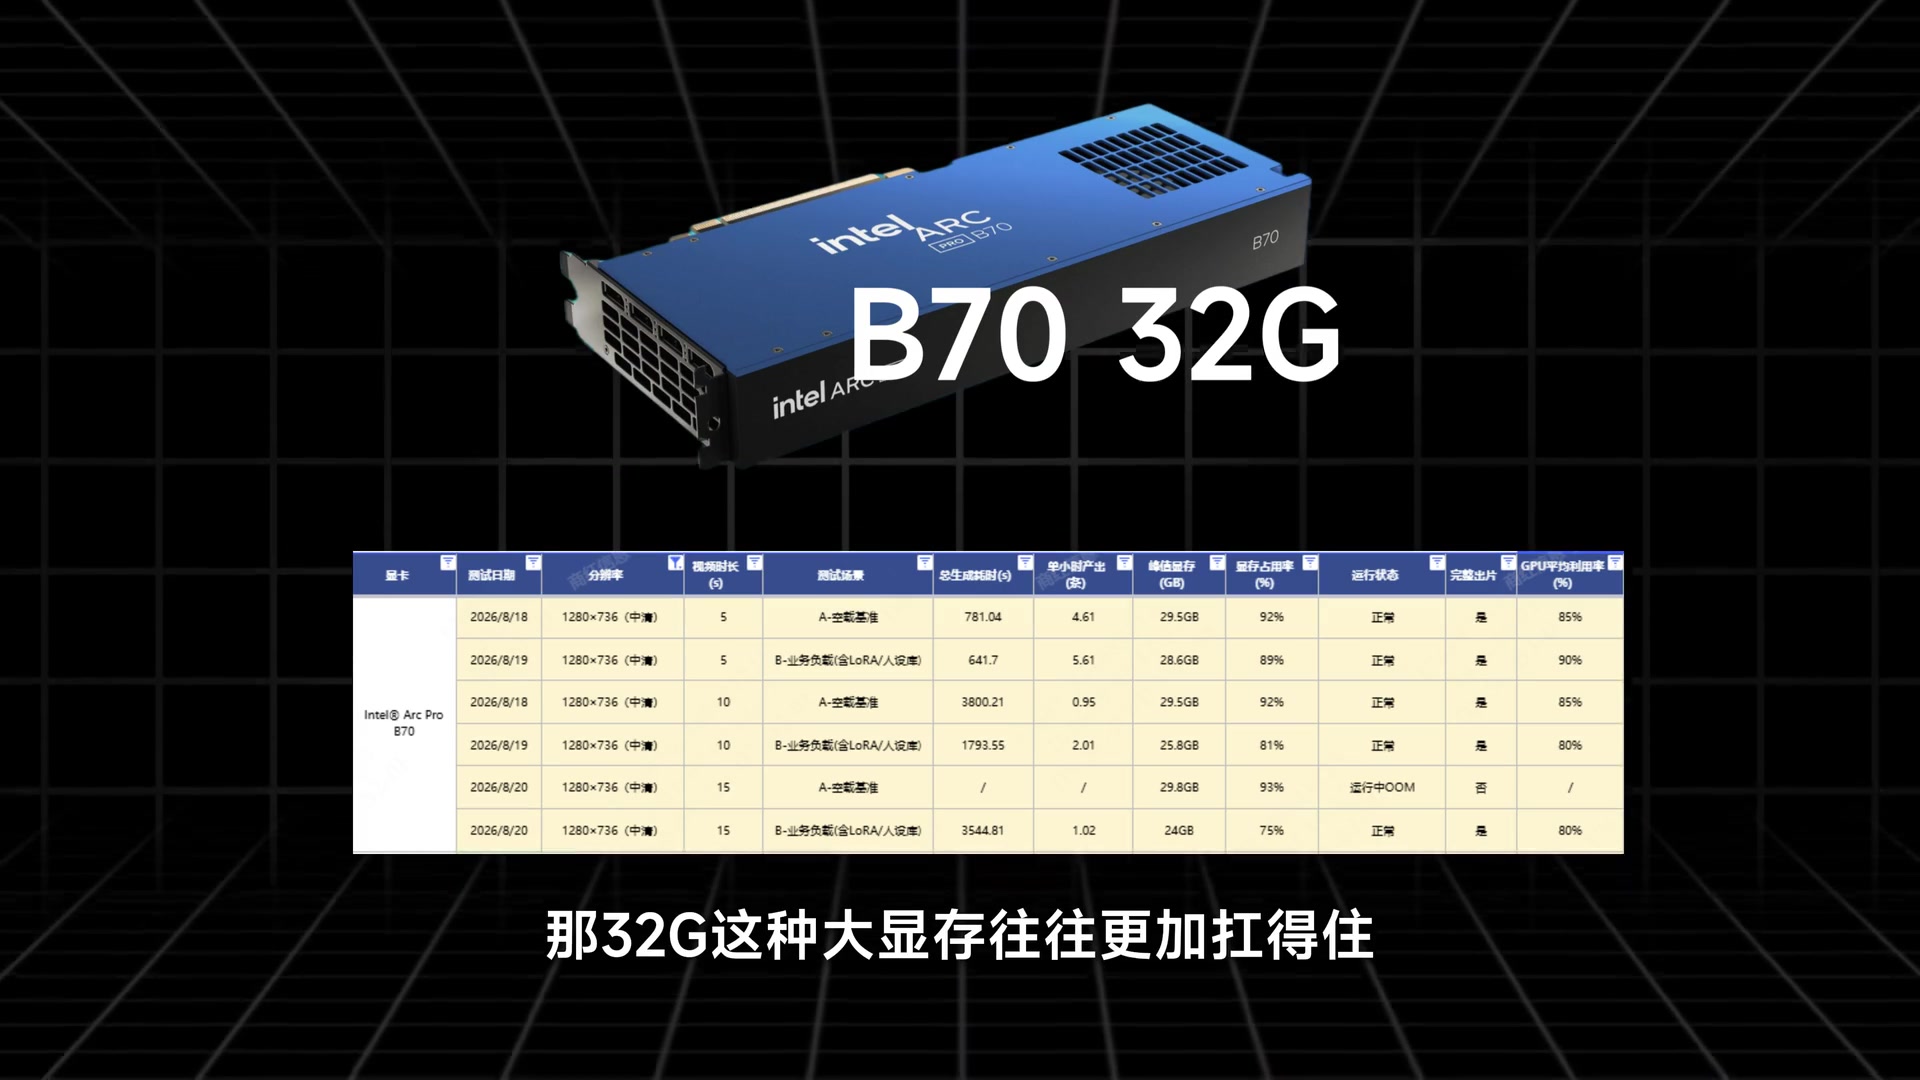
B70 全部 16 条记录里,B 档的产能是:低清 5s 98.40、10s 59.56、15s 38.17;中清 5s 22.22、10s 9.41、15s 4.93;1080P 5s 7.42、10s 2.39 条/小时。
换成更直观的说法:同样跑 5 秒镜头,低清能到 98 条/小时,1080P 掉到 7.42 条/小时——分辨率抬一档,产能要砍掉一个数量级。中清是折中点,5 秒 22.22 条/小时。
| 分辨率 | 5s | 10s | 15s |
|---|---|---|---|
| 低清 | 98.40 条/小时(36.59s/条) | 59.56 条/小时(60.44s/条) | 38.17 条/小时(94.33s/条) |
| 中清 | 22.22 条/小时(162.00s/条) | 9.41 条/小时(382.50s/条) | 4.93 条/小时(730.16s/条) |
| 1080P | 7.42 条/小时(485.11s/条) | 2.39 条/小时(1503.79s/条)⚠️临界 | — |
这张表决定了一件很实在的事:如果要接 1080P 的订单,一条 10 秒镜头要 25 分钟。 一部漫剧按 100 条镜头算,单机满负荷跑一周左右——这就是为什么漫剧工作室算产能时,看的是"显存能不能撑住高清档",而不是"跑分高不高"。
定级标准是这样的:显存占用 ≤80%、完整出片、画面无异常、可稳定重复运行 ≥3 次,才算安全区。
按这个标准,B70 的 8 个 B 档里有 7 个在安全区,只有 1080P/10s 落在临界区——那一条峰值显存 31.9GB、占用 100%。
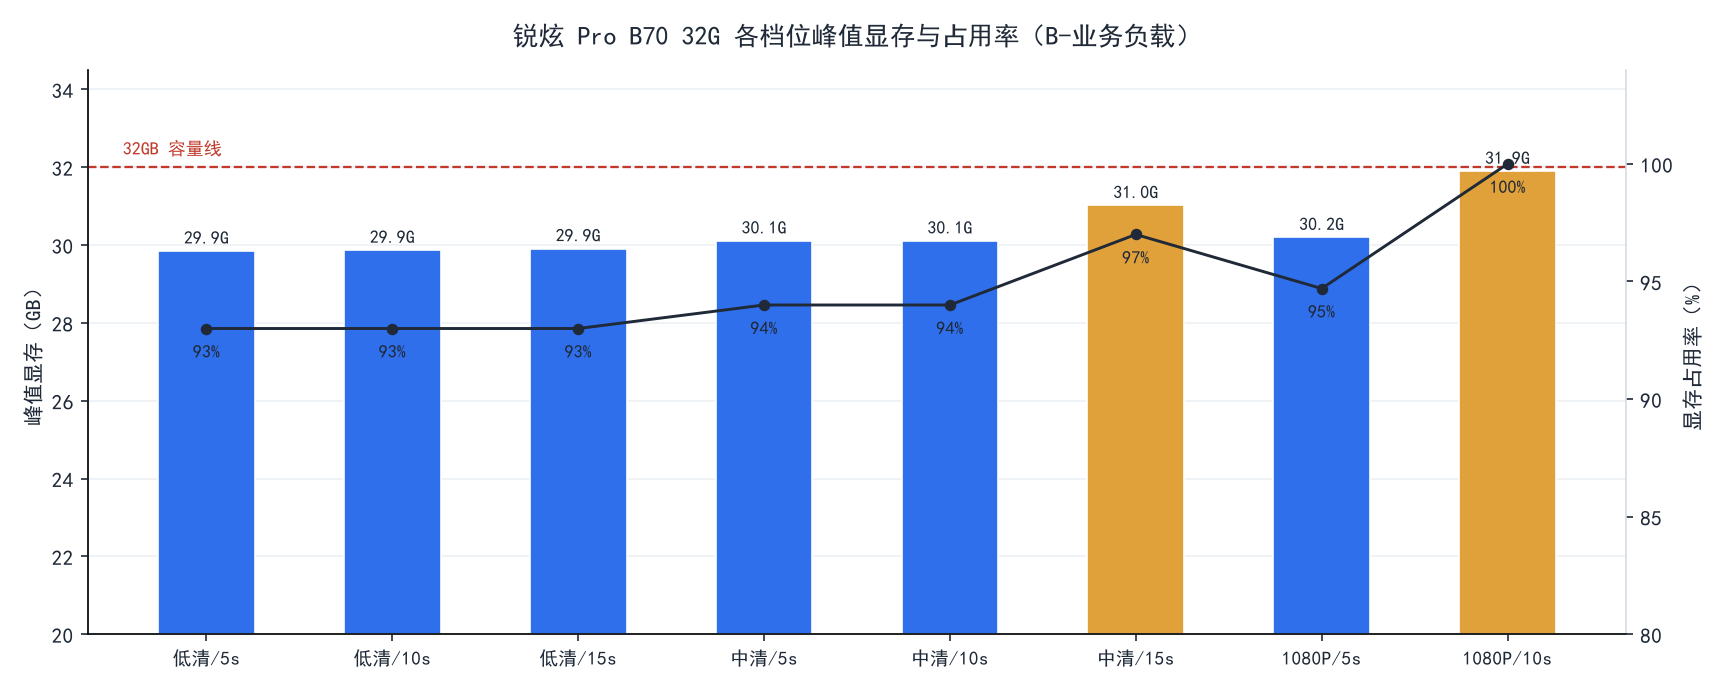
B70 的显存峰值落在 28.8–31.9GB 区间,占用率 90%–100%。1080P/10s 触及 100%,按标准划入临界区。
这个划分不是文字游戏,它直接决定能不能签合同:占用 90% 出头还能跑,说明机器还有喘气的空间;顶到 100%,就意味着这一档"能出片,但没有冗余",叠加新的业务组件(更多 LoRA、更长镜头、多人排队)时风险会立刻升上来。临界区只能做 Demo,不能承诺商用——这句话在销售口径里是要写进方案的。
顺带看一眼对照组的边界:RTX 5070-12G 在中清/15s 就进入临界区(占用 97%),1080P/10s 直接超时中断、判为不可用;RTX 5060Ti-16G 和 5080-16G 的 1080P/10s 也在临界区。12G / 16G 这一档,高清长镜头不是"慢",是"过不去"。
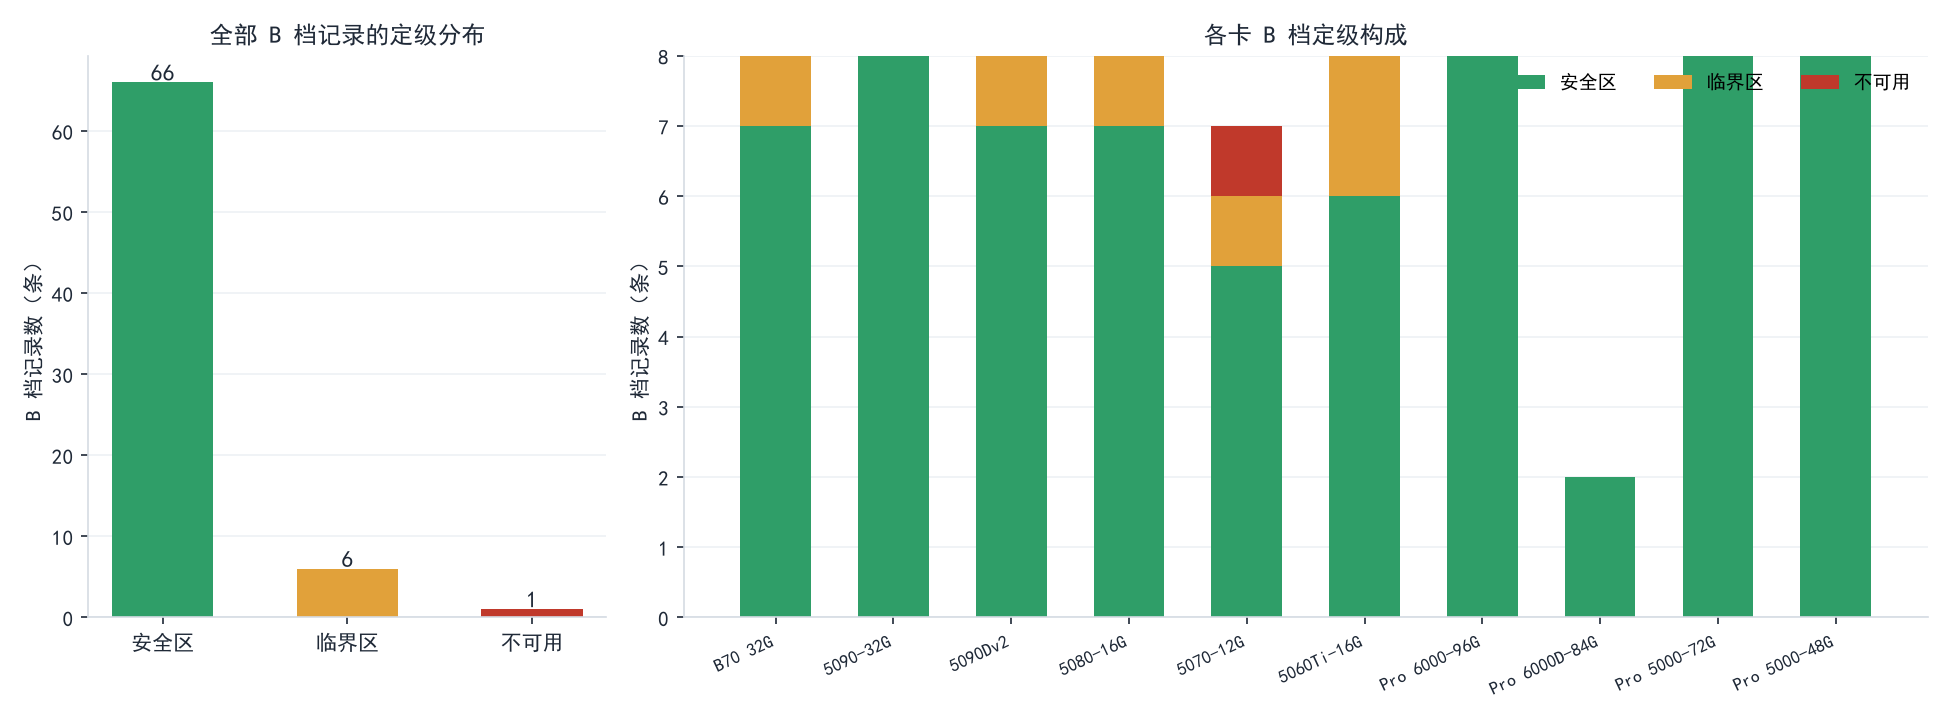
146 条记录中 B 档的定级分布,以及各卡的构成。绿=安全区,橙=临界区,红=不可用。
先说结论:它顶不住的是"1080P 长镜头批量",不是"AI 漫剧"这个业务本身。
第一条,1080P/10s 已经在临界区,1080P/15s 这一档这批数据里根本没人跑通(10 张卡都没测)。如果你的订单里 1080P 长镜头占比高,要么降到时长的短档、要么上双卡拆生成与超分,要么直接去看 Pro 系列的更高显存档。
第二条,它跑不过 RTX Pro 6000-96G,差距在多数档位是 +2% 到 +27%(1080P/5s 反而快 2%)。但那是一张完全不同的价位段的卡——这批数据不含价格字段,选型时要把"多花的钱"和"多出来的 2%–27% 产能"放在一起算。
第三条,它是 SYCL / oneAPI 生态,不是 CUDA。同时支持 OpenVINO、Intel Extension for PyTorch,也能对接 vLLM、ComfyUI、Docker,但团队里已经堆了一整套 CUDA 自定义算子的话,迁移是要花时间的。
第四条,这批数据是厂商实验室自测,不是第三方测评;且源表没记录 CPU 型号、系统内存、驱动版本、采样步数、CFG 与随机种子——这意味着它足以支撑选型判断,但不足以让你逐帧复现。要复现,得把这些字段补齐。
按漫剧产线的实际产量分三档,从"先验证"到"稳定量产"再到"该上服务器了"。显卡之外,内存与存储要一起配。
| 档位 | 适用情况 | 建议配置方向 | 产能预期(B 档) |
|---|---|---|---|
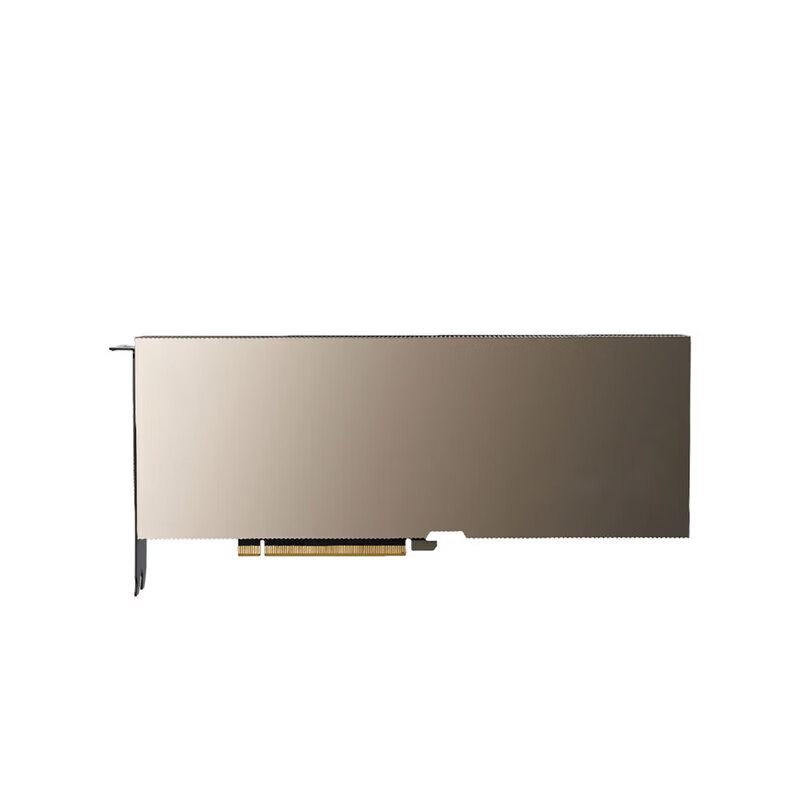
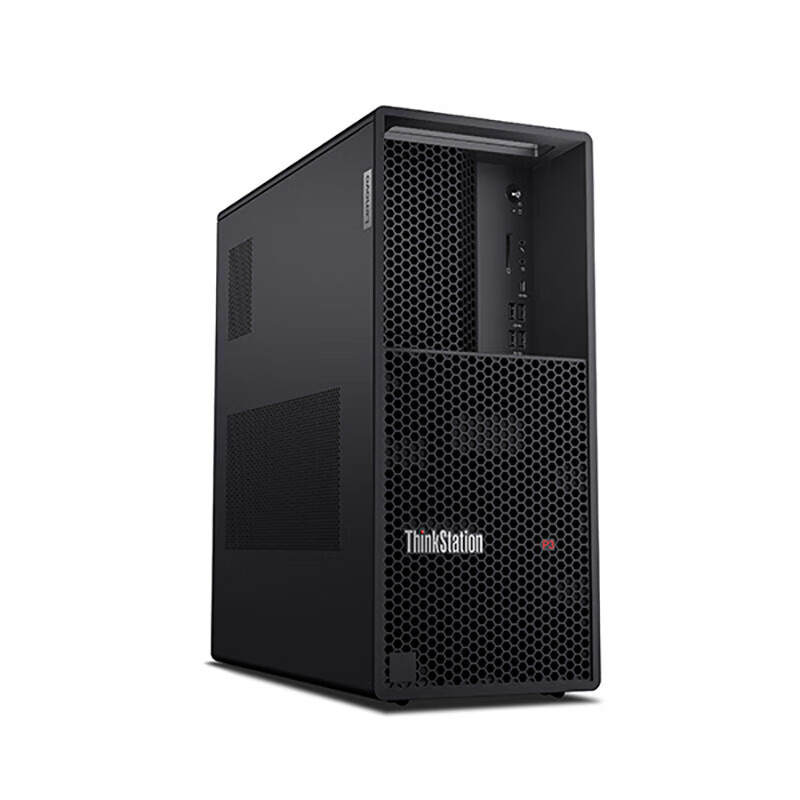
| 验证档 | 先跑通链路,判断本地是否适合自己 | 单张 B70 32G + 双宽塔式平台,DDR5 内存配足(视频生成大量调用系统内存做 offload) | 低清 5s 约 98 条/小时,够验证画质与节奏 |
| 量产档 | 每天稳定出片,生成与剪辑并行 | 单卡 B70 承担生成 + 同机剪辑(10 轨以上 4K 能力),或双卡拆生成与超分 | 中清 5s 约 22 条/小时,1080P 5s 约 7 条/小时 |
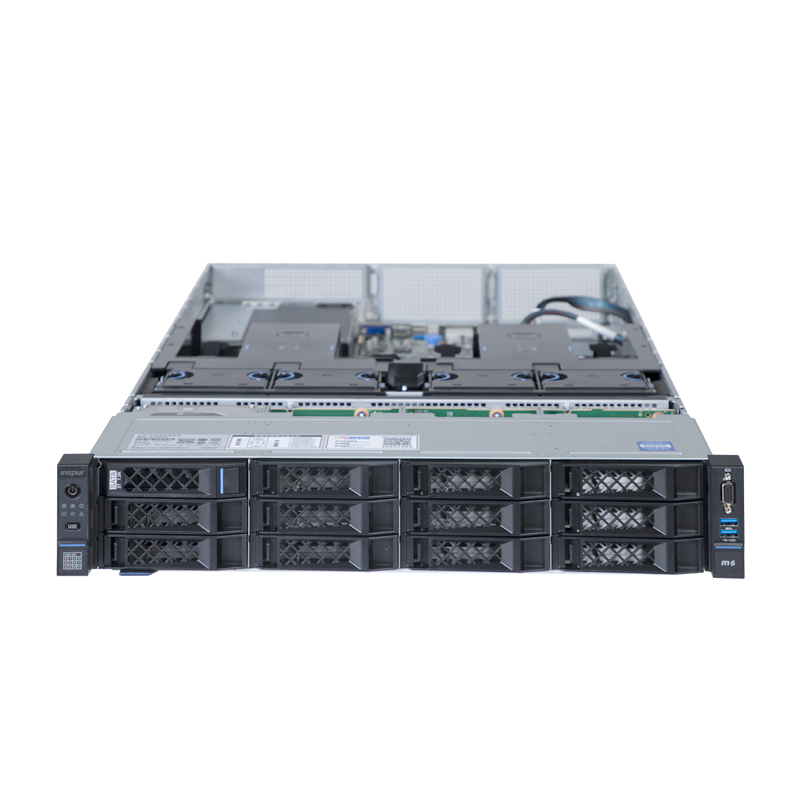
| 集群档 | 多人并发、每天上百条、1080P 长镜头为主 | 转向多卡服务器与队列调度 | 单机产能已到上限,该按集群规划 |
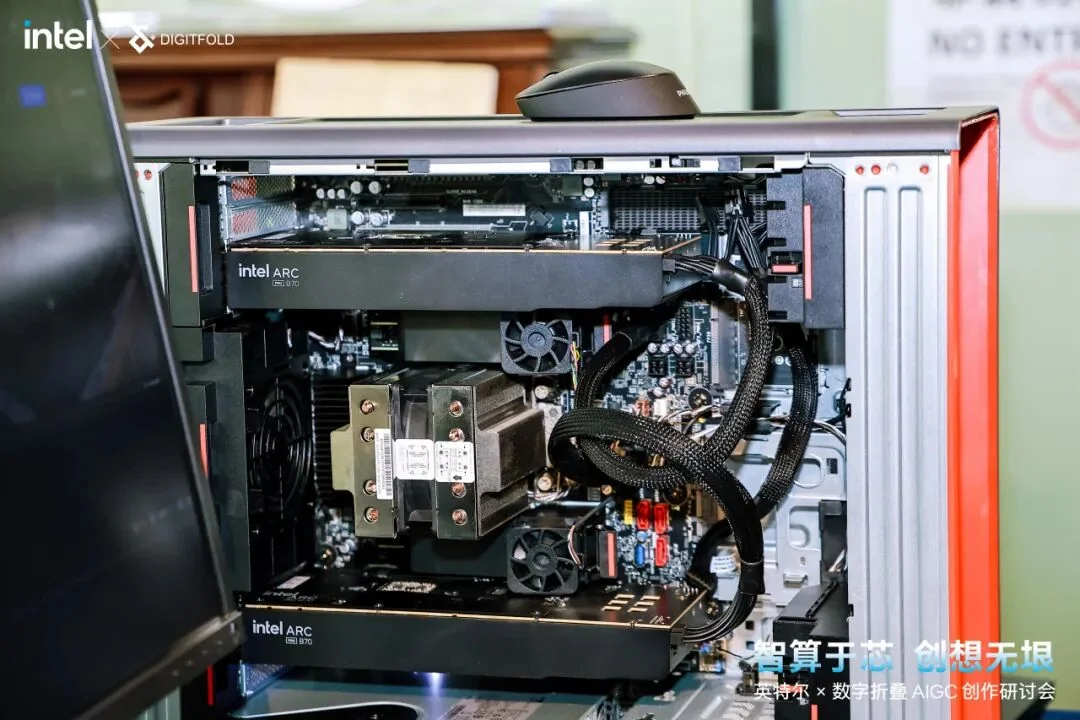
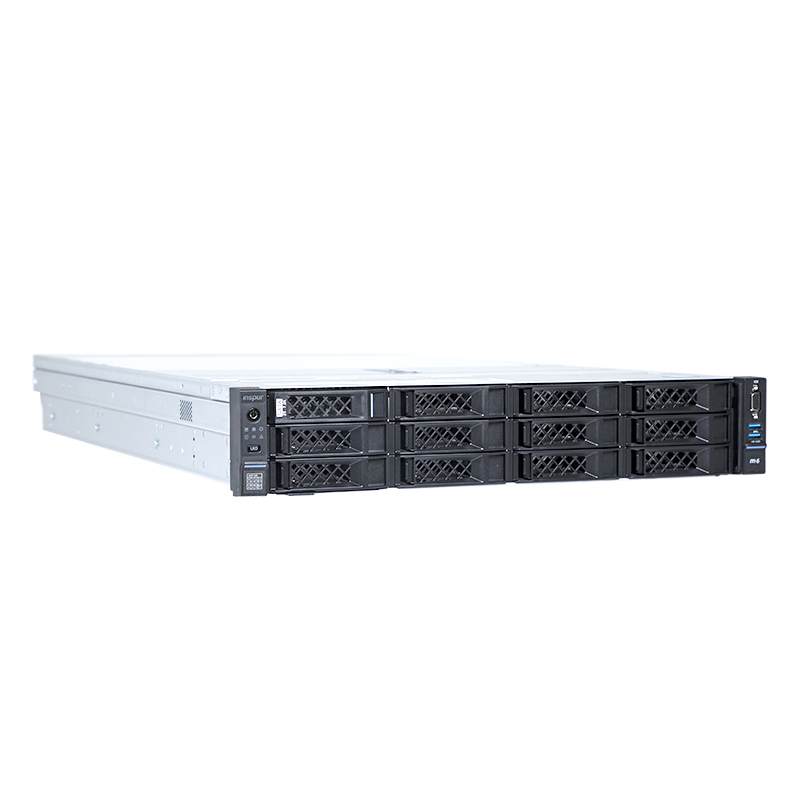
整机侧常见形态:双宽专业卡 + 大尺寸散热。长时间连续生成,散热和电源余量比跑分更值得关注。
这批数据里还有一个容易被忽略的细节:146 条记录中有 6 条温控"温度偏高",全部出现在 12G / 16G 卡占用 97%–98% 的那几格。B70 的 16 条记录温控全部稳定。贴着显存上限跑的卡,热量也是贴着上限的。
Q1:做 AI 漫剧,一定要 32G 显存吗?
看你接什么单。低清、中清档位 12G/16G 也能出片,但产能只有 B70 的 3%–66%;1080P/10s 这一档,5070-12G 直接超时中断判为不可用。要接高清长镜头订单,32G 是那道门槛。
Q2:B70 和 RTX Pro 6000-96G 差多少?
多数档位差 2%–27%,Pro 6000-96G 略快;1080P/5s 档位 B70 反而快 2%。这批数据不含价格,值不值要看两台机器的差价与这 2%–27% 的产能怎么折算。
Q3:为什么 1080P/10s 被判成临界区,但还是能出片?
它完整出片了,产能 2.39 条/小时,但峰值显存 31.9GB、占用 100%,没有冗余。按定级标准"可出片但无冗余"只能划入临界区——能跑不等于能承诺,这是交付时最容易出分歧的地方。
Q4:这套方案可以拿我的素材先试吗?
可以。商红科技一般建议带一段真实素材和几组提示词跑一轮:先看目标分辨率下的单条耗时,再看显存峰值落在哪一档,最后看排队跑一晚的稳定性。跑到这一步,"该买单卡还是双卡"就不需要别人替你判断了。
要一份按你的镜头表(分辨率、时长、每天条数)算过的配置清单,或者想把上面这套测试在你自己的素材上复现一轮,可以联系我们,也可以看产品中心里对应的显卡与整机组合。咨询热线 400-0755-816。
延伸阅读:MiniMax H3 开源:8 卡 NF5468M7 撑起本地视频生成整条产线|联想 ThinkStation PX 本地部署大模型|RTX Pro 系列专业显卡选型指南 | AI漫剧本地生成要多大显存?锐炫Pro B70 32G方案参数、实测与配置清单
2026-10-27
2026-10-22

2026-10-22
2026-10-22
2026-10-22
2026-10-22
2026-10-22
2026-10-14
2026-10-14
扫码关注



